
📋 本章概览
| 信息 | 详情 |
|---|---|
| 考试领域 | Plan and manage an Azure AI solution |
| 考试权重 | 25% |
| 建议时长 | 180 分钟 |
| 难度 | ⭐⭐ 中等 |
| 前置知识 | 完成第 1 章 Azure AI 概述 |
📢 为什么这章重要:25% 的考试权重意味着大约 12-13 道题来自这个领域。而且这些知识不只是考试考——在企业里部署 AI 方案,"选对服务、配好安全、控好成本"比写代码更重要。
🎯 学习目标
完成本章后,你将能够:
- ✅ 根据业务需求选择正确的 Azure AI 服务和定价层
- ✅ 配置 Azure AI 资源的网络安全(VNET、Private Endpoint)
- ✅ 使用 Entra ID 和 RBAC 管理 AI 服务的访问权限
- ✅ 配置诊断日志和监控指标
- ✅ 理解 Responsible AI 原则并在方案中落地
- ✅ 规划 AI 方案的容量、成本和区域部署
知识地图
规划和管理 Azure AI 方案
│
├── 服务选型 ────────── 选对工具比写对代码更重要
│   ├── 预建 vs 自定义模型
│   ├── 定价层选择 (Free / Standard / Enterprise)
│   └── 区域可用性和延迟考量
│
├── 安全与合规 ──────── AI 工程师的"安全底线"
│   ├── 认证:API Key vs Entra ID (RBAC)
│   ├── 网络:VNET 集成 + Private Endpoint
│   ├── 数据加密:传输中 (TLS) + 静态 (CMK)
│   └── Key Vault 管理密钥
│
├── 部署与容器 ──────── 边缘和离线场景
│   ├── 容器化部署(Docker)
│   └── 断线环境(Disconnected containers)
│
├── 监控与诊断 ──────── 上线后才是开始
│   ├── Azure Monitor + Diagnostic Settings
│   ├── Log Analytics 查询
│   └── 告警规则配置
│
└── Responsible AI ──── 微软的 AI 价值观
    ├── 六大原则
    ├── Content Safety 实施
    └── 透明度和问责
🔧 服务选型:选对工具是第一步
预建模型 vs 自定义模型
拿到一个 AI 需求时,你面临的第一个决策就是:用现成的还是自己训练?
| 维度 | 预建模型 (Pre-built) | 自定义模型 (Custom) | 一句话记忆 |
|---|---|---|---|
| 开发时间 | 几分钟(调 API 就行) | 几天到几周(需要标注数据+训练) | 快 vs 慢 |
| 数据需求 | 不需要自己的数据 | 需要标注好的训练数据 | 零数据 vs 要数据 |
| 精度 | 通用场景够用 | 特定场景更准 | 80 分通用 vs 95 分专精 |
| 成本 | 按 API 调用付费 | 训练 + 推理双重成本 | 用多少付多少 vs 先投资后使用 |
| 适用 | 情感分析、OCR、翻译 | 产品缺陷检测、行业文档分类 | 常见任务 vs 专业任务 |
⚠️ 考试技巧:题目如果说"快速上线""无需额外数据""通用需求"——选预建。说"特定行业""自有数据集""高精度要求"——选自定义。
定价层对照
术语:SKU / Pricing Tier(定价层)
- 一句话解释:Azure 服务的"套餐等级",不同等级有不同的调用限额、功能和价格。
- 形象比喻:手机套餐——Free 是免费套餐(每月 5000 次调用,够你试用),Standard 是正式套餐(不限量但按量付费),Enterprise 是 VIP 套餐(有 SLA 保障和高级功能)。
- 考试怎么考:"客户需要每秒处理 100 个请求,应该选什么定价层?"——Free 上限是 20 TPS,必须选 Standard 或更高。
- 最易混淆:Free tier 在功能上可能有限制(比如不支持 Custom Neural Voice),不只是调用量的区别。
| 定价层 | TPS 限制 | 适用场景 | 注意事项 |
|---|---|---|---|
| Free (F0) | 20 TPS | 开发测试、PoC | 功能可能不全,有月调用上限 |
| Standard (S0) | 可提升 | 生产工作负载 | 按量付费,支持 SLA |
| Enterprise | 高 TPS | 大规模企业应用 | 专属资源,高级安全 |
区域选择策略
不是所有 Azure AI 服务在每个区域都可用。选区域时考虑这几点:
- 服务可用性:Azure OpenAI 目前只在特定区域可用(如 East US、West Europe、Japan East)
- 数据驻留:有些行业要求数据不能出国(如 GDPR 要求数据留在欧洲)
- 延迟:离用户越近,响应越快
- 配对区域:Azure 的灾备会用配对区域——了解你的主区域配对是谁
⚠️ 考试陷阱:如果题目说"客户在澳大利亚,需要使用 Azure OpenAI"——你得检查 Australia East 是否支持 OpenAI。不支持的话就得选最近的可用区域(如 Japan East),而不是硬选本地区域。
🔒 安全与合规
这张图对应“管理”考点:方案上线后不仅要能跑,还要可观测、可审计、可告警。
认证方式对比
这是考试高频考点——Azure AI 服务有两种认证方式,企业场景几乎一定要用 Entra ID。
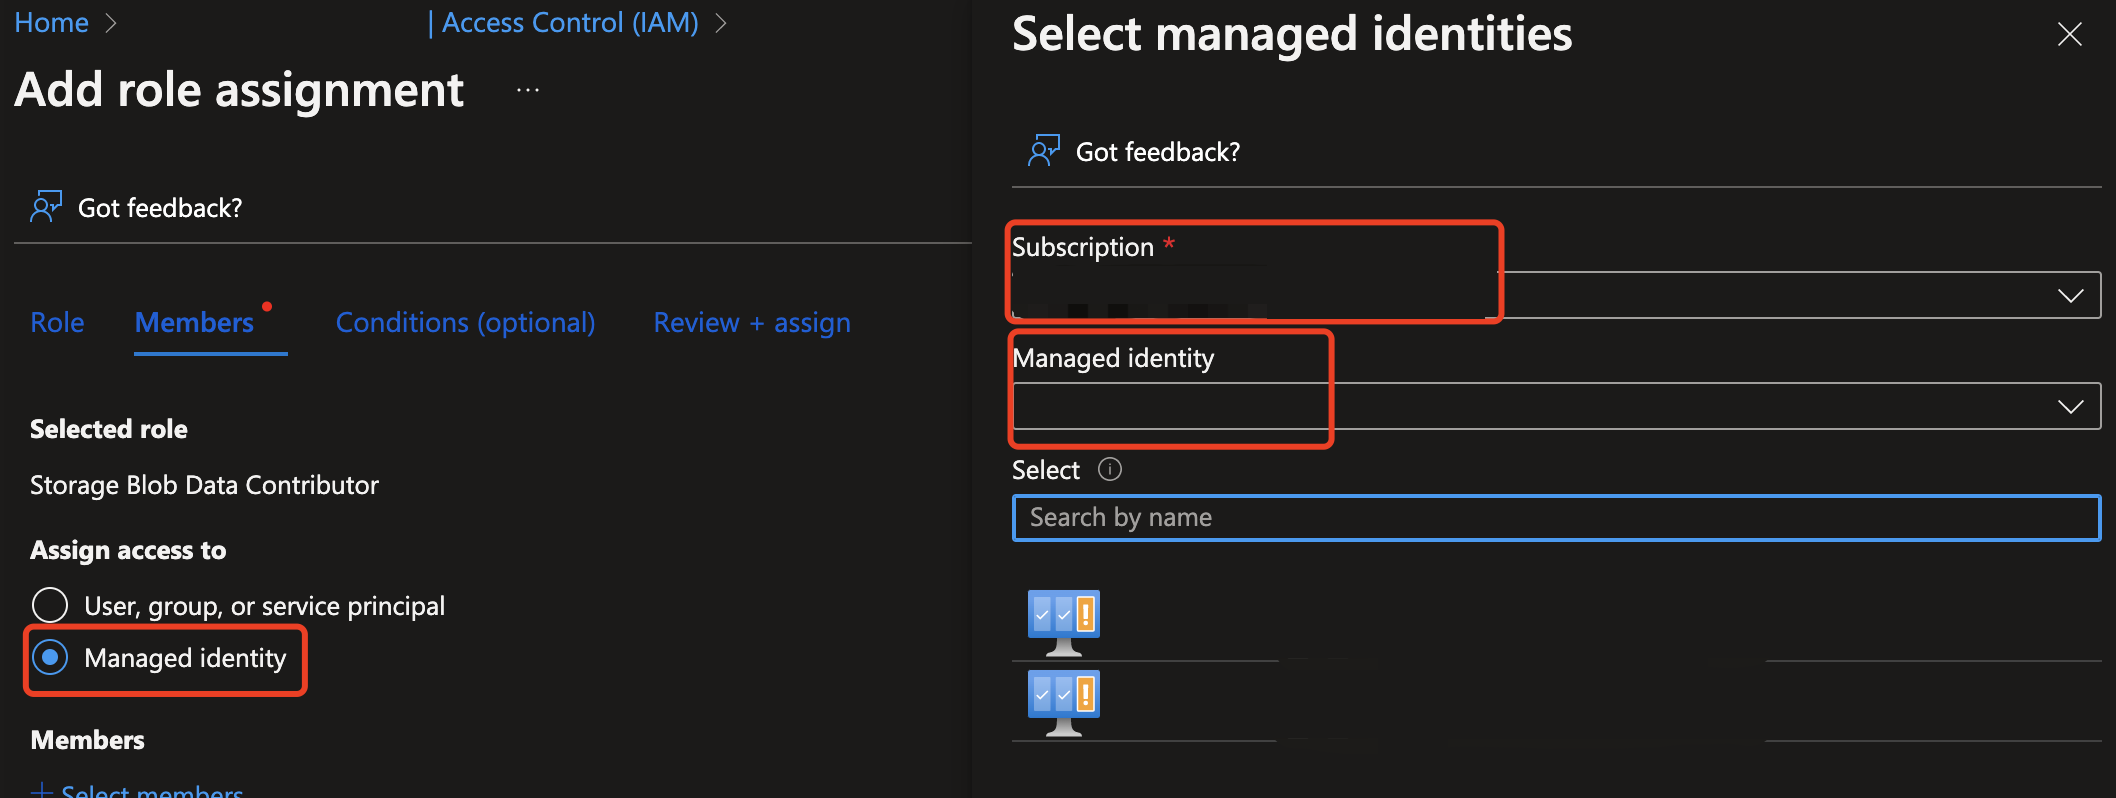
这张图对应 RBAC 授权配置,考试里凡是“最安全访问方式”通常都要落到 Managed Identity + 角色分配。
API Key 认证(简单但不安全)
─────────────────────────
客户端 → Header: Ocp-Apim-Subscription-Key: <key> → Azure AI Service
         ↑
         密钥写死在代码里或环境变量里
         任何拿到 key 的人都能调用
         没有细粒度权限控制


Entra ID 认证(安全、推荐)
─────────────────────────
客户端 → Entra ID → 获取 Token → Azure AI Service
         ↑                        ↑
         用 Managed Identity      RBAC 控制谁能做什么
         不需要管理密钥            支持条件访问
         可审计每次调用            最小权限原则
术语:Managed Identity(托管标识)
- 一句话解释:Azure 自动帮你的应用创建和管理的身份凭证,你不需要在代码里写任何密码或密钥。
- 形象比喻:公司给你配的工牌——你不用自己做工牌,公司发给你,凭工牌进各个房间,离职时公司自动注销。
- 考试怎么考:"Web App 需要安全地访问 Azure AI Services,不在代码中存储凭证"——答案是 System-assigned Managed Identity + RBAC 角色赋值。
- 最易混淆:System-assigned(跟资源绑定,资源删则身份删)vs User-assigned(独立存在,可以绑多个资源)。
网络安全
术语:Private Endpoint(私有终结点)
- 一句话解释:让你的 Azure AI 服务只能通过你自己的虚拟网络访问,而不是通过公网。
- 形象比喻:给 AI 服务装一个"内线电话"——只有公司内网的人能拨打,外面的人连号码都看不到。
- 考试怎么考:"确保 AI 服务流量不经过公网"——Private Endpoint。"限制特定子网访问"——VNET Service Endpoint 或 Private Endpoint。
- 最易混淆:Service Endpoint 只是改变路由路径(流量走 Azure 骨干网),但服务仍有公网 IP。Private Endpoint 是真正的私有 IP,服务彻底"隐身"。
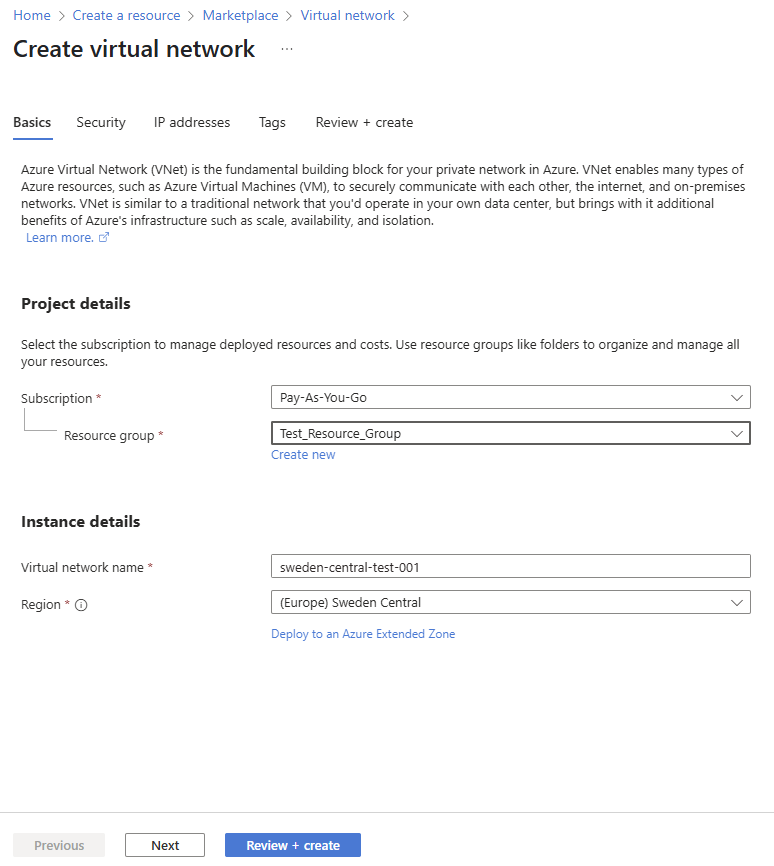
这张图用于理解“默认网络边界”考点:哪些流量路径仍可能经过公网,哪些控制点可以收紧访问。
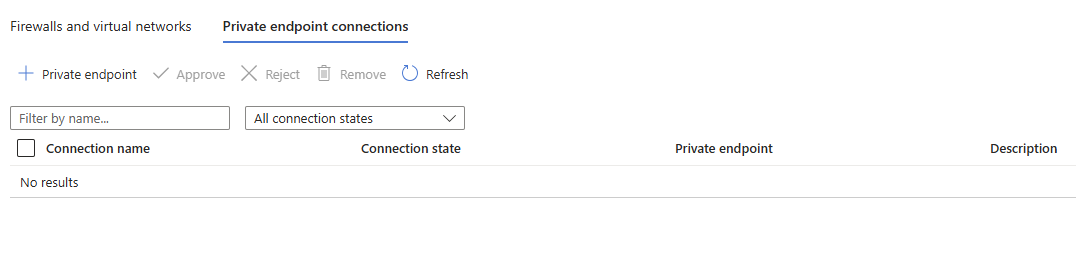
这张图用于记忆 Private Endpoint 落地方式:考试题干出现“仅内网访问/禁止公网暴露”时优先匹配这类架构。
| 网络方案 | 安全级别 | 流量路径 | 适用场景 | 一句话记忆 |
|---|---|---|---|---|
| 公网访问 | 低 | 走公网 | 开发测试 | "谁都能来敲门" |
| 防火墙规则 | 中 | 走公网,白名单过滤 | 已知 IP 范围 | "只开门给认识的人" |
| Service Endpoint | 中高 | 走 Azure 骨干网 | 同 VNET 内服务 | "走公司内部通道" |
| Private Endpoint | 高 | 私有 IP,完全不走公网 | 生产/合规要求 | "装了内线电话" |
Key Vault 密钥管理
即使你用 API Key,也不能把 key 写死在代码里。正确做法是放在 Key Vault 里。
# ❌ 错误做法:密钥硬编码
client = TextAnalyticsClient(
    endpoint="https://myai.cognitiveservices.azure.com",
    credential=AzureKeyCredential("abc123...")  # 密钥暴露在代码中!
)

# ✅ 正确做法 1:Managed Identity(最佳)
from azure.identity import DefaultAzureCredential
client = TextAnalyticsClient(
    endpoint="https://myai.cognitiveservices.azure.com",
    credential=DefaultAzureCredential()  # 自动使用 Managed Identity
)

# ✅ 正确做法 2:Key Vault(次优)
from azure.keyvault.secrets import SecretClient
secret_client = SecretClient(vault_url="https://myvault.vault.azure.net",
                              credential=DefaultAzureCredential())
key = secret_client.get_secret("ai-service-key").value
⚠️ 考试优先级:Managed Identity > Key Vault + API Key > 环境变量 API Key > 硬编码 API Key。题目问"最安全的方式",永远选 Managed Identity。
📦 容器化部署
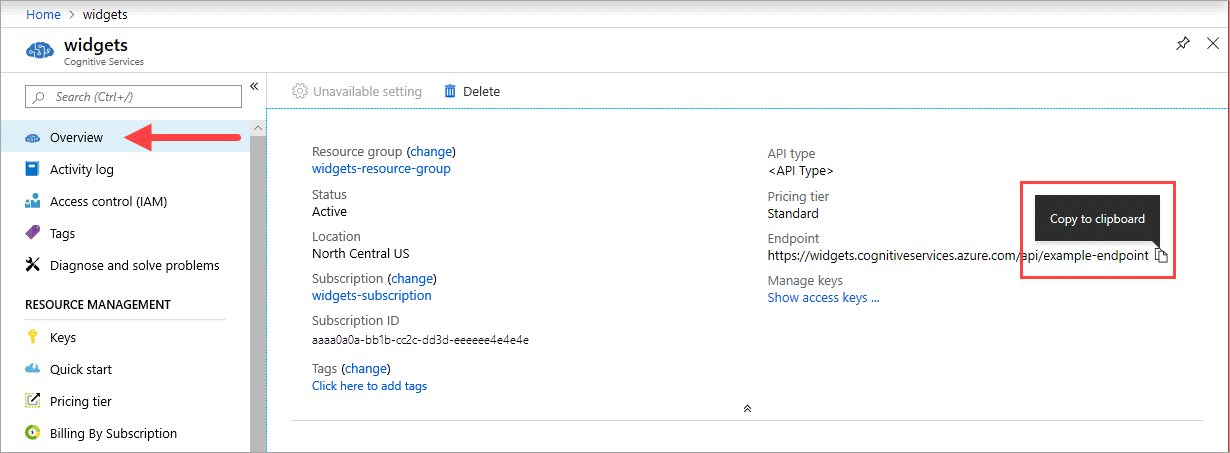
这张图对应容器化落地场景:离线或边缘部署时,客户端通过本地容器端点访问模型能力。
为什么要把 AI 服务装进容器?
有些场景下你不能或不想把数据发到 Azure 云端:
- 数据合规:医疗/金融数据不能出内网
- 网络限制:工厂、船舶等断网环境
- 延迟要求:实时推理需要毫秒级响应
Azure AI Services 支持把部分服务打包成 Docker 容器,部署在本地或边缘设备上。
术语:Disconnected Container(断线容器)
- 一句话解释:可以在完全没有网络的环境下运行的 Azure AI 容器。
- 形象比喻:把外卖厨师请到家里做饭——平时你去餐厅(云端),但特殊情况下厨师上门(本地容器),做出来的菜一样。
- 考试怎么考:"在没有互联网的工厂环境中使用 OCR"——选 Disconnected Container。注意:需要定期联网上报使用量(计费要求)。
- 最易混淆:普通容器需要保持网络连接;Disconnected Container 才是真正的离线模式,但需要提前申请。
容器化部署架构
──────────────────────────────────
│  本地/边缘环境                  │
│  ┌────────────────────────┐    │
│  │ Docker Container       │    │
│  │ ┌──────────────────┐   │    │
│  │ │ Azure AI Model    │   │    │
│  │ │ (Vision/Language/│   │    │
│  │ │  Speech)          │   │    │
│  │ └──────────────────┘   │    │
│  │        ↑ ↓             │    │
│  │    REST API 端点        │    │
│  │    localhost:5000       │    │
│  └────────────────────────┘    │
│           ↕ 定期连网上报计费    │
──────────────────────────────────
            ↕
    Azure(许可验证 + 计费)
支持容器化的服务
| 服务 | 容器支持 | 断线支持 | 常见场景 |
|---|---|---|---|
| Language (Text Analytics) | ✅ | ✅ | 本地文档分析 |
| Vision (OCR/Read) | ✅ | ✅ | 工厂产线文字识别 |
| Speech-to-Text | ✅ | ✅ | 离线语音转写 |
| Translator | ✅ | ❌ | 需要连网 |
| Face API | ✅ | ❌ | 需要连网 |
| Azure OpenAI | ❌ | ❌ | 仅云端,不支持容器 |
⚠️ 考试重点:Azure OpenAI 不支持容器化部署。如果题目要求"在本地运行 GPT 模型"——答案不是 Azure OpenAI 容器,而是考虑其他开源模型或 Azure AI on Edge 方案。
📊 监控与诊断
上线后的"体检系统"
部署完 AI 服务不是终点——你需要持续监控它的健康状态。
术语:Diagnostic Settings(诊断设置)
- 一句话解释:告诉 Azure "我想收集哪些日志和指标,发送到哪里去"。
- 形象比喻:给 AI 服务装了行车记录仪+油量表——记录仪记下每次调用(日志),油量表显示实时状态(指标)。
- 考试怎么考:"需要分析过去 7 天 AI 服务的调用模式"——启用 Diagnostic Settings → 发送到 Log Analytics Workspace → 用 KQL 查询。
监控架构
──────────────────────────────────────────
Azure AI Service
    │
    ├── Metrics(指标)─── Azure Monitor
    │   ├── Total Calls(调用总数)
    │   ├── Latency(延迟)
    │   ├── Successful Calls(成功数)
    │   └── Errors(错误数)
    │
    ├── Logs(日志)───── Log Analytics
    │   ├── Request logs(每次 API 调用详情)
    │   ├── Audit logs(配置变更记录)
    │   └── Trace logs(诊断追踪)
    │
    └── Alerts(告警)─── Action Group
        ├── 邮件通知
        ├── SMS
        ├── Webhook
        └── Azure Function 触发
常用 KQL 查询示例
// 查看过去 24 小时的错误请求
AzureDiagnostics
| where ResourceType == "COGNITIVESERVICES"
| where ResultType != "Success"
| where TimeGenerated > ago(24h)
| summarize ErrorCount = count() by ResultType, OperationName
| order by ErrorCount desc

// 分析 API 调用延迟分布
AzureDiagnostics
| where ResourceType == "COGNITIVESERVICES"
| where TimeGenerated > ago(7d)
| summarize avg(DurationMs), percentile(DurationMs, 95) by bin(TimeGenerated, 1h)
💡 备考建议:不需要背 KQL 语法,但要能看懂查询意图。考试可能给你一段 KQL,问你"这个查询在做什么"或"怎么修改才能满足需求"。
🤝 Responsible AI(负责任的 AI)
微软的六大 AI 原则
这不是空话——考试真的会考,而且是微软的价值观题,答案方向很明确。
| 原则 | 含义 | 考试应用场景 | 一句话记忆 |
|---|---|---|---|
| Fairness 公平性 | 不因种族、性别等产生偏见 | 模型训练数据要多样化 | "一碗水端平" |
| Reliability 可靠性 | 在各种条件下稳定工作 | 测试边界情况和错误处理 | "不能只在理想条件下好用" |
| Privacy 隐私 | 保护用户数据 | 数据加密、最小化收集 | "用户的数据不是你的" |
| Inclusiveness 包容性 | 让所有人都能使用 | 无障碍设计、多语言支持 | "不能只服务一部分人" |
| Transparency 透明度 | 用户知道在和 AI 交互 | AI 输出带来源标注 | "告诉用户这是 AI 说的" |
| Accountability 问责制 | 有人为 AI 行为负责 | 建立审查流程和反馈通道 | "出了问题找得到人" |
⚠️ 考试重点:Responsible AI 题目的答案一般倾向于"更安全、更透明、更公平"的选项。如果两个选项技术上都可行,选更符合 Responsible AI 原则的那个。
Content Safety 实施
Azure AI Content Safety 是 Responsible AI 在实操层面的落地工具。
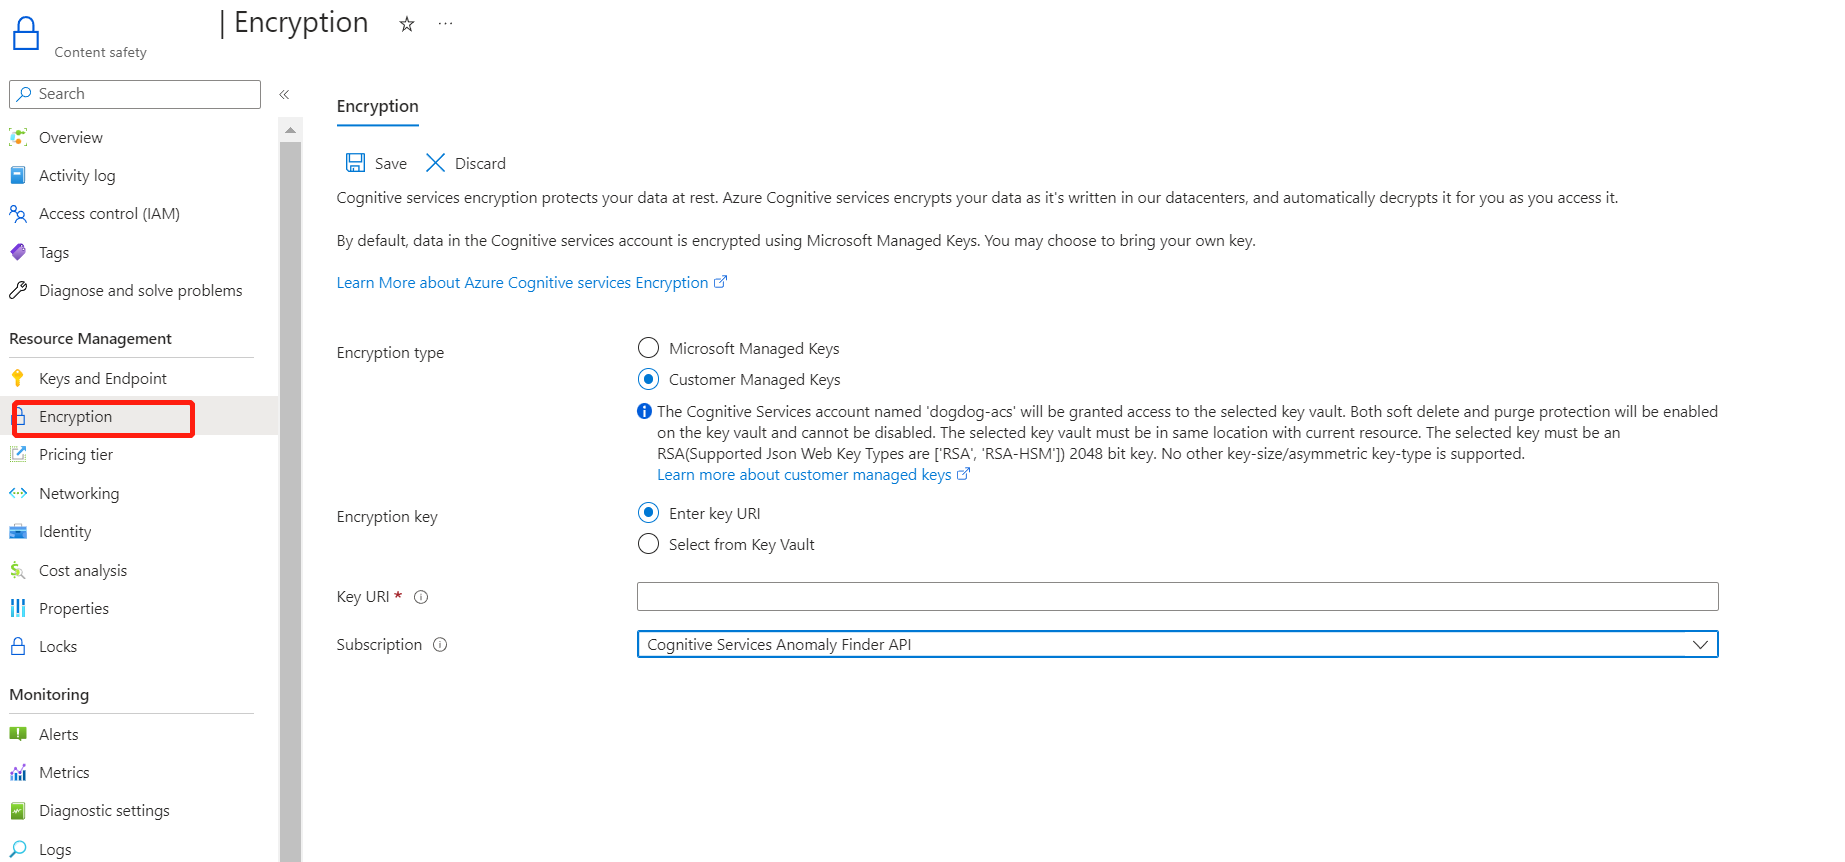
这张图强调“隐私与合规”考点:内容审核数据的加密链路,是企业审计场景常见要求。
这张图强调“持续治理”考点:不仅要做审核,还要看告警趋势与命中分布来调整阈值策略。
Content Safety 工作流
─────────────────────────────
用户输入
    │
    ↓
Azure AI Content Safety
    ├── 暴力 (Violence) ──── 0-6 严重度评分
    ├── 仇恨 (Hate) ─────── 0-6 严重度评分
    ├── 色情 (Sexual) ────── 0-6 严重度评分
    └── 自残 (Self-harm) ── 0-6 严重度评分
    │
    ↓
    严重度 > 阈值?
    ├── 是 → 拦截,返回安全提示
    └── 否 → 放行,继续处理
💡 实用技巧:Content Safety 的阈值可以调节。业务场景不同,阈值也不同——医疗系统讨论"自残"是正常的,社交平台则需要更严格的过滤。
💰 成本管理
AI 服务计费模型
| 计费方式 | 说明 | 适用服务 | 一句话记忆 |
|---|---|---|---|
| 按 API 调用 | 每次调用收费 | Vision, Language, Speech | "用一次付一次" |
| 按 Token | 输入+输出 token 数计费 | Azure OpenAI | "字越多越贵" |
| 按页/图 | 处理的文档页数或图片数 | Document Intelligence | "看多少页收多少钱" |
| 按数据量 | 索引数据量 + 查询次数 | Azure AI Search | "存多少、查多少" |
成本优化策略
- 用 Free tier 做开发测试——别用 Standard 跑 PoC
- 缓存重复请求——同样的图片/文本不要重复调 API
- 选对模型大小——GPT-4o-mini 比 GPT-4o 便宜 10 倍,简单任务够用
- 设置预算告警——Azure Cost Management 里配一个月度预算上限
📝 本章小结
| 考点 | 关键知识 | 出题频率 |
|---|---|---|
| 认证方式 | Entra ID + RBAC > API Key | ⭐⭐⭐⭐⭐ |
| 网络安全 | Private Endpoint vs Service Endpoint | ⭐⭐⭐⭐ |
| 容器化 | 哪些服务支持容器/断线 | ⭐⭐⭐⭐ |
| 服务选型 | 预建 vs 自定义、定价层选择 | ⭐⭐⭐⭐ |
| Responsible AI | 六大原则 + Content Safety | ⭐⭐⭐ |
| 监控 | Diagnostic Settings + KQL | ⭐⭐⭐ |
| 密钥管理 | Managed Identity > Key Vault > 硬编码 | ⭐⭐⭐⭐⭐ |