
📖 考试简介 (Exam Introduction)
AWS Certified AI Practitioner (AIF-C01) 是 AWS 在 2024 年推出的全新认证,专门面向希望验证自己在 AI、ML 和生成式 AI 领域基础知识的从业者。这张证书不要求你会写代码,也不需要你手动训练模型——它考察的是你对 AI/ML 概念的理解,以及你在 AWS 平台上使用 AI 服务的能力。
简单来说,如果你是产品经理、业务分析师、项目经理,或者刚刚接触 AI 领域的开发者,这张认证就是为你量身定制的。
考试基本信息
| 项目 | 详情 |
|---|---|
| 考试代码 | AIF-C01 |
| 考试时长 | 90 分钟 |
| 题目数量 | 65 道(50 道计分,15 道不计分) |
| 通过分数 | 700/1000 |
| 题型 | 单选题、多选题 |
| 考试费用 | $75 USD |
| 有效期 | 3 年 |
| 语言 | English, 中文(简体), 日本語 等 |
| 前置要求 | 无(但建议有 6 个月 AI/ML 接触经验) |
📚 官方考试指南: AWS AIF-C01 Exam Guide (PDF)
⚠️ 考试重点: 注意 15 道不计分的题目是实验题,你无法区分哪些计分哪些不计分,所以每道题都要认真对待。90 分钟做 65 道题,平均每道题不到 1.5 分钟,时间相当紧凑。
🎯 考试内容分布 (Exam Content Breakdown)
AIF-C01 考试涵盖五个主要领域,每个领域的权重不同。理解这个分布非常关键,它直接决定了你的备考策略。
五大考试领域
| Domain | 名称 | 权重 | 优先级 |
|---|---|---|---|
| Domain 1 | Fundamentals of AI and ML (AI 与 ML 基础) | 20% | ⭐⭐⭐ |
| Domain 2 | Fundamentals of Generative AI (生成式 AI 基础) | 24% | ⭐⭐⭐⭐ |
| Domain 3 | Applications of Foundation Models (基础模型应用) | 28% | ⭐⭐⭐⭐⭐ |
| Domain 4 | Guidelines for Responsible AI (负责任 AI 准则) | 14% | ⭐⭐ |
| Domain 5 | Security and Compliance for AI Solutions (AI 安全与合规) | 14% | ⭐⭐ |
你会发现,Domain 3 占比最高(28%),这意味着 AWS 非常看重你是否能将基础模型(如 Amazon Bedrock)应用到实际场景中。紧随其后的是 Domain 2(24%),生成式 AI 是当前考试的核心热点。这两个领域加起来超过了 50%,是你备考的绝对重点。
备考时间建议分配
| 领域 | 建议学习时间 |
|---|---|
| Domain 1: AI/ML 基础 | 15-20 小时 |
| Domain 2: 生成式 AI 基础 | 20-25 小时 |
| Domain 3: 基础模型应用 | 25-30 小时 |
| Domain 4: 负责任 AI | 10-12 小时 |
| Domain 5: 安全合规 | 10-12 小时 |
💡 什么是 AI?从最基础的概念说起
Artificial Intelligence (人工智能),简称 AI,是让机器模拟人类智能行为的技术总称。
打个比方:AI 就像你培养一个实习生。你不是直接告诉他每一步怎么做,而是通过大量的案例和经验,让他自己学会判断和决策。有的实习生只能做简单的分类工作(这是传统 AI),有的能自己写报告、画图、做分析(这是生成式 AI)。
AI 不是一个单一技术,而是一个庞大的技术家族。它包括:
- 规则系统 (Rule-based Systems): 用 if-else 逻辑做决策,最早的 AI 形式
- Machine Learning (机器学习): 让机器从数据中自己学习规律
- Deep Learning (深度学习): 用神经网络处理更复杂的任务
- Generative AI (生成式 AI): 能创造新内容的 AI
⚠️ 考试重点: 考试会让你区分这些概念的边界。记住:所有 ML 都是 AI,但不是所有 AI 都是 ML。同理,所有 Deep Learning 都是 ML,但不是所有 ML 都是 Deep Learning。
💡 什么是 Machine Learning?
Machine Learning (机器学习) 是 AI 的一个子领域,核心思想是:不需要人类显式编写规则,而是让机器从数据中自动学习模式和规律。
传统编程和机器学习的区别非常重要:
传统编程:  输入数据 + 规则 → 输出结果
机器学习:  输入数据 + 期望结果 → 学习规则
举个例子来理解。传统编程判断一封邮件是不是垃圾邮件,你需要手动写规则:"如果包含'免费领取'就是垃圾邮件"。但规则写不完,骗子会不断换词。机器学习的方式不同——你给它 10 万封邮件(标记好哪些是垃圾邮件),让它自己发现规律。也许它会发现,垃圾邮件不仅含特定词汇,还倾向于在凌晨发送、使用特定格式。这些规律你可能永远想不到,但机器能从数据中自己挖掘出来。
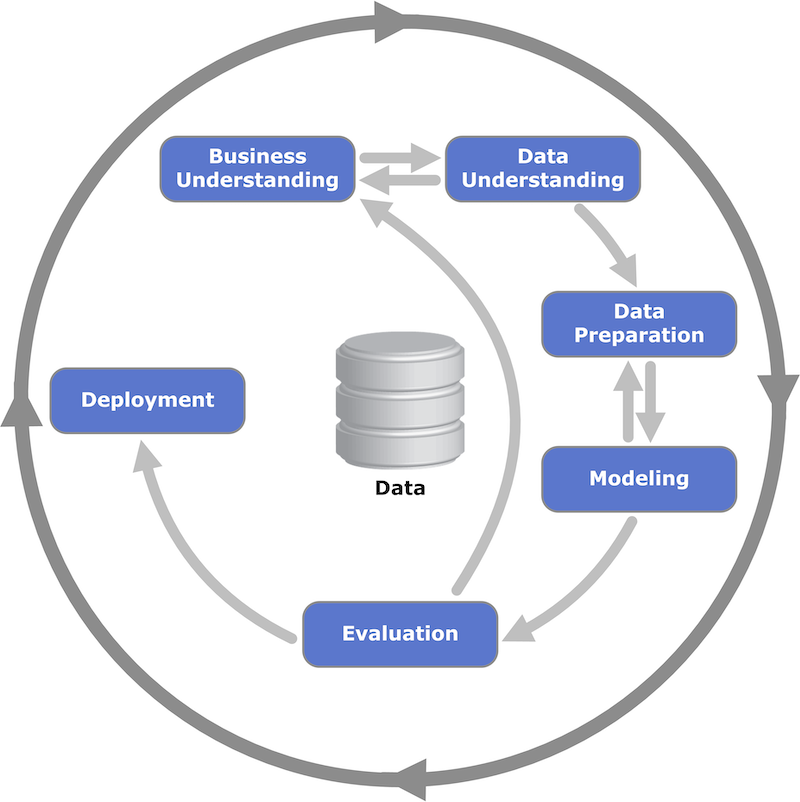
这张图适合作为第一章开场配图:AIF-C01 不只考“模型是什么”,还会考“AI 项目怎么落地”,尤其是数据准备、评估和上线后的反馈循环。
⚠️ 考试重点: AWS 考试喜欢问"什么时候该用 ML,什么时候用传统编程"。如果规则明确、不经常变化,用传统编程就好。如果数据量大、规律复杂、需要持续适应变化,就该考虑 ML。
💡 什么是 Deep Learning?
Deep Learning (深度学习) 是 Machine Learning 的一个子集,使用多层 Neural Networks (神经网络) 来学习数据中的复杂模式。
如果说 ML 是实习生能做简单的分类和预测,那 Deep Learning 就是这个实习生经过了多年训练,能处理图像识别、语音翻译、自然语言理解这类极其复杂的任务。"Deep"指的是神经网络的层数很多(深),不是说学习内容有多"深奥"。
Deep Learning 之所以在近年爆发,有三个关键原因:
- 数据量暴增: 互联网每天产生海量数据
- 算力提升: GPU 和云计算让训练大规模模型成为可能
- 算法突破: 特别是 2017 年 Transformer 架构的出现
🎯 AI vs ML vs Deep Learning 的关系
这三者是一个嵌套关系,用下面这张图来理解:
这张图适合考前速记概念边界:遇到“AI/ML/Deep Learning 概念区分题”时,用这类嵌套关系图快速排除错误选项。
┌─────────────────────────────────────────────────────────┐
│                                                         │
│   Artificial Intelligence (人工智能)                      │
│   所有模拟人类智能的技术                                    │
│                                                         │
│   ┌─────────────────────────────────────────────────┐   │
│   │                                                 │   │
│   │   Machine Learning (机器学习)                     │   │
│   │   从数据中自动学习规律                               │   │
│   │                                                 │   │
│   │   ┌─────────────────────────────────────────┐   │   │
│   │   │                                         │   │   │
│   │   │   Deep Learning (深度学习)                │   │   │
│   │   │   使用多层神经网络                          │   │   │
│   │   │                                         │   │   │
│   │   │   ┌─────────────────────────────────┐   │   │   │
│   │   │   │  Generative AI (生成式 AI)       │   │   │   │
│   │   │   │  能创造新内容                      │   │   │   │
│   │   │   └─────────────────────────────────┘   │   │   │
│   │   │                                         │   │   │
│   │   └─────────────────────────────────────────┘   │   │
│   │                                                 │   │
│   └─────────────────────────────────────────────────┘   │
│                                                         │
└─────────────────────────────────────────────────────────┘
快速对比表
| 特征 | AI | ML | Deep Learning |
|---|---|---|---|
| 范围 | 最广 | AI 的子集 | ML 的子集 |
| 核心思路 | 模拟人类智能 | 从数据学规律 | 用深层神经网络 |
| 是否需要数据 | 不一定 | 必须 | 需要大量数据 |
| 典型例子 | 规则引擎、专家系统 | 推荐系统、垃圾邮件 | 图像识别、语音助手 |
| AWS 服务举例 | Amazon Lex (聊天机器人) | Amazon SageMaker | Amazon Rekognition |
⚠️ 考试重点: 考试中常见的混淆点是把 AI 和 ML 当同义词。记住 AI 是一个更广泛的概念,它包含不需要数据学习的方法(如规则引擎),而 ML 一定需要数据驱动。
💡 机器学习的三大类型
这是 AIF-C01 考试最核心的基础知识之一。ML 根据学习方式的不同,分为三大类型。
1. Supervised Learning (监督学习)
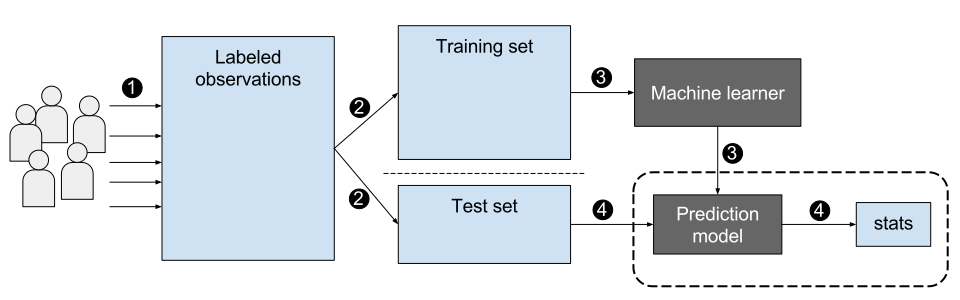
Supervised Learning 就像是一个有标准答案的考试。你给模型一堆"带正确答案的"训练数据,让它学会输入和输出之间的映射关系。
比喻:就像老师批改作文。老师看了 1000 篇标注了分数的作文(Training Data + Labels),然后学会了给新作文打分的标准。
监督学习分为两大任务类型:
Classification (分类): 预测离散的类别
- 邮件是垃圾邮件还是正常邮件?(二分类)
- 这张图片是猫、狗还是鸟?(多分类)
- AWS 服务: Amazon Comprehend(文本情感分类)
Regression (回归): 预测连续的数值
- 明天的温度是多少度?
- 这套房子值多少钱?
- AWS 服务: Amazon Forecast(时间序列预测)
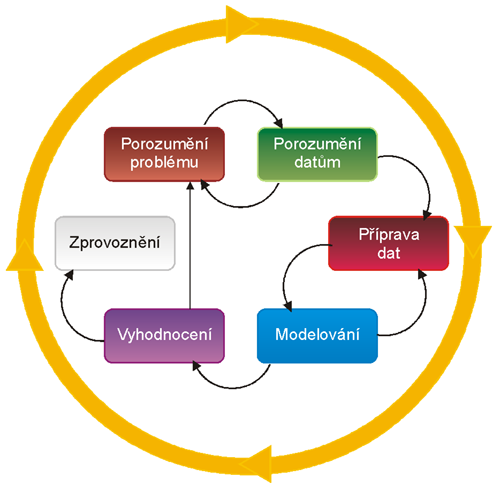
这张图对应“项目落地流程”类题目:AIF-C01 不只考模型概念,也会考从业务到部署的完整步骤意识。
2. Unsupervised Learning (无监督学习)
Unsupervised Learning 是没有标准答案的学习。你只给模型一堆数据,不告诉它正确答案是什么,让它自己发现数据中的隐藏结构和规律。
比喻:就像让一个人对一堆没有标签的照片进行分组。没有人告诉他怎么分,但他可能会自己发现"这些都是风景照"、"这些都是人物照"。
常见任务类型:
Clustering (聚类): 把相似的数据分到一组
- 客户分群:哪些客户的消费行为相似?
- AWS 服务: Amazon Personalize 底层使用聚类
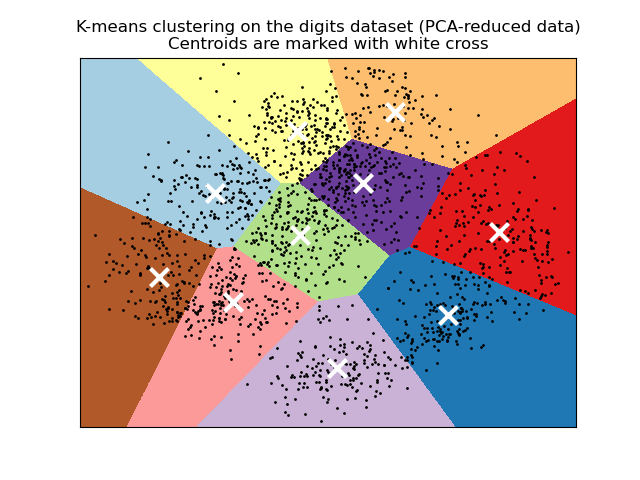
这张图用于快速理解“无监督分群”题型:重点是没有标签也能形成可解释的簇结构。
Dimensionality Reduction (降维): 简化数据,保留关键信息
- 把 100 个特征压缩成 10 个最重要的
- PCA (Principal Component Analysis) 是最经典的降维算法
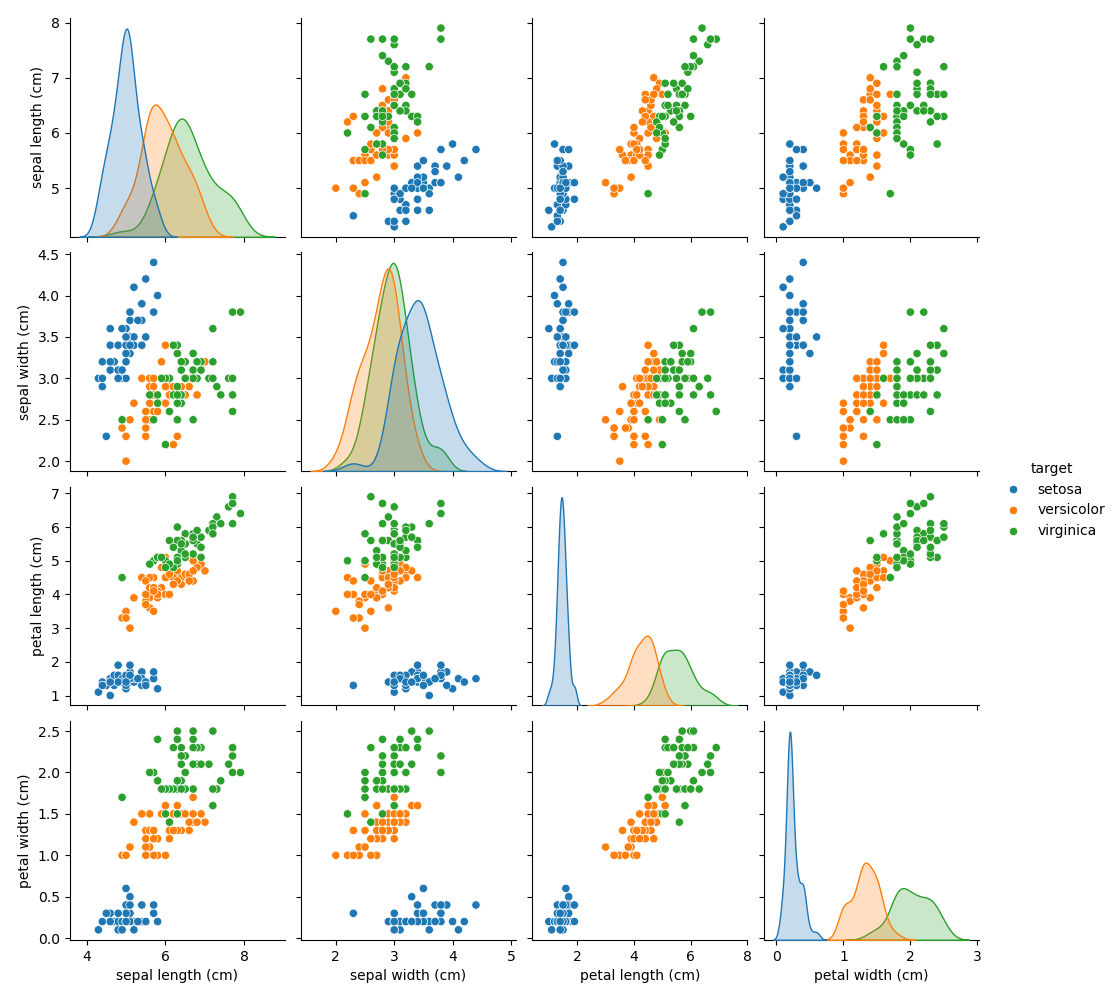
这张图对应降维考点:压缩特征维度后仍尽量保持数据结构和可分性。
Anomaly Detection (异常检测): 找出不正常的数据点
- 信用卡欺诈检测
- AWS 服务: Amazon Lookout for Metrics
3. Reinforcement Learning (强化学习)
Reinforcement Learning (RL) 是让 Agent(智能体)通过与环境交互,根据奖励和惩罚来学习最优策略。
比喻:就像训练一只狗。你不是直接告诉它该怎么做,而是它做对了给零食(奖励),做错了不给(惩罚)。通过不断尝试,它学会了什么行为能获得最大奖励。
RL 的核心概念:
- Agent (智能体): 做决策的主体
- Environment (环境): Agent 所处的世界
- State (状态): 当前环境的情况
- Action (动作): Agent 的行为选择
- Reward (奖励): 对行为的反馈
AWS 服务: Amazon SageMaker 支持 RL 训练,AWS DeepRacer 就是一个经典的 RL 应用——自动驾驶小赛车通过 RL 学习赛道策略。
三种学习类型对比
| 类型 | 数据特征 | 比喻 | 典型场景 |
|---|---|---|---|
| Supervised | 有标签 (Labeled) | 有答案的考试 | 分类、预测 |
| Unsupervised | 无标签 (Unlabeled) | 自由分组 | 聚类、降维 |
| Reinforcement | 奖惩信号 | 训练宠物 | 游戏、机器人 |
⚠️ 考试重点: 考试经常给你一个业务场景,让你判断应该用哪种类型。关键判断标准是:数据有没有标签。如果题目提到"历史标注数据"、"标记好的训练集",就是 Supervised。如果提到"发现隐藏模式"、"没有标签",就是 Unsupervised。如果提到"通过试错学习"、"最大化奖励",就是 Reinforcement。
🎯 机器学习开发生命周期 (ML Development Lifecycle)
在 AWS 考试中,你需要理解一个完整的 ML 项目是如何从头到尾运作的。这个生命周期不是线性的,而是一个持续迭代的过程。
问题定义 → 数据收集 → 数据准备 → 特征工程 → 模型训练 → 模型评估 → 部署 → 监控
    ↑                                                                    |
    └────────────────────────── 持续迭代 ──────────────────────────────────┘
Step 1: 问题定义 (Problem Definition)
这一步决定了整个项目的成败。在动手之前,你需要搞清楚几件事:
- 这个问题真的需要 ML 来解决吗?(也许简单的规则就够了)
- 成功的标准是什么?(准确率需要达到多少?)
- 有足够的数据吗?数据质量如何?
- 这是分类问题、回归问题还是其他?
Step 2: 数据收集 (Data Collection)
ML 模型的表现上限取决于数据质量。Garbage in, garbage out——喂进去的数据是垃圾,出来的结果也是垃圾。
AWS 相关服务:
- Amazon S3: 存储训练数据
- AWS Glue: 数据目录和 ETL
- Amazon Kinesis: 实时数据收集
Step 3: 数据准备 (Data Preparation)
数据科学家 80% 的时间都花在数据准备上。这包括清洗缺失值、处理异常值、转换数据格式等。这个比例听起来夸张,但确实反映了现实——原始数据往往非常"脏"。
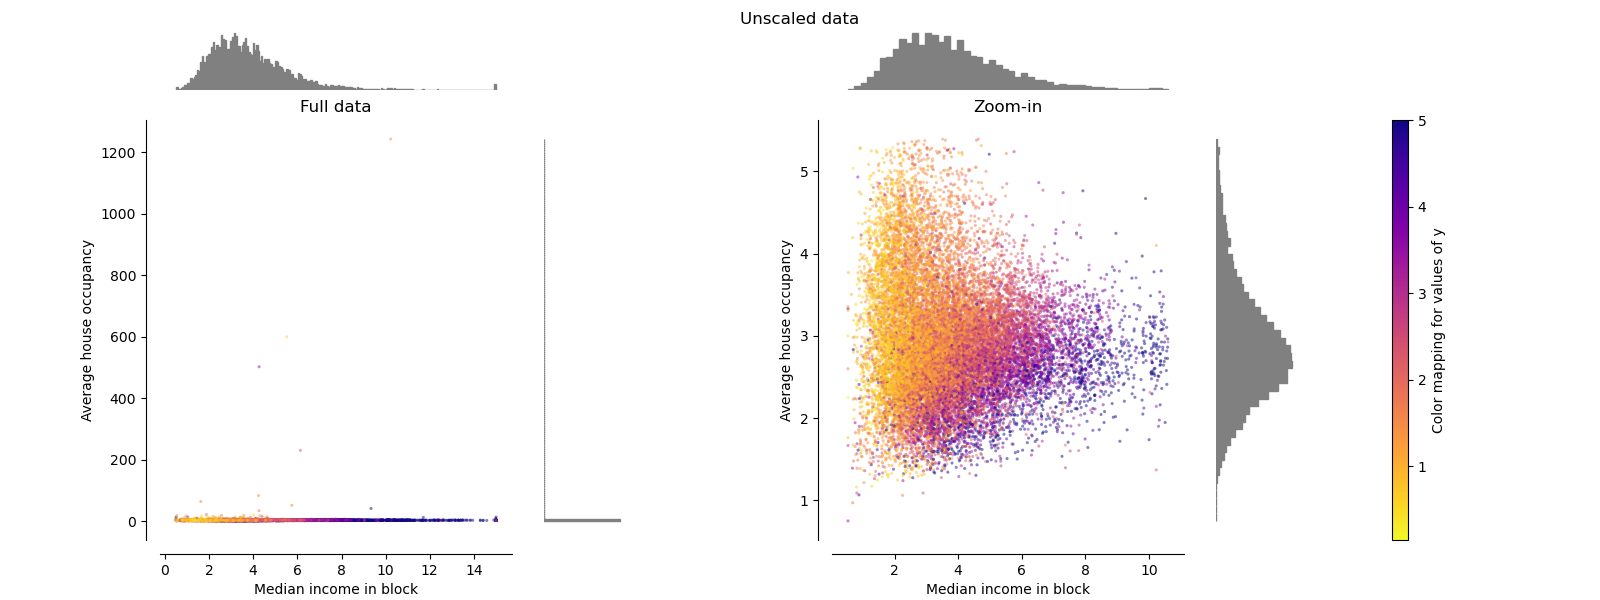
这张图用于记忆“预处理影响模型表现”这一点:同一数据在不同缩放策略下,模型效果可能差很多。
Step 4: 特征工程 (Feature Engineering)
Feature (特征) 是模型用来做预测的输入变量。Feature Engineering 就是从原始数据中提取出对预测最有帮助的信息。
比如预测房价,原始数据可能只有地址,但通过特征工程你可以提取出"到地铁的距离"、"周边学校数量"等更有用的特征。
Step 5: 模型训练 (Model Training)
用准备好的数据来训练模型。这一步涉及选择算法、设置 Hyperparameters(超参数),然后让模型从数据中学习。
AWS 服务: Amazon SageMaker 提供了完整的训练环境。
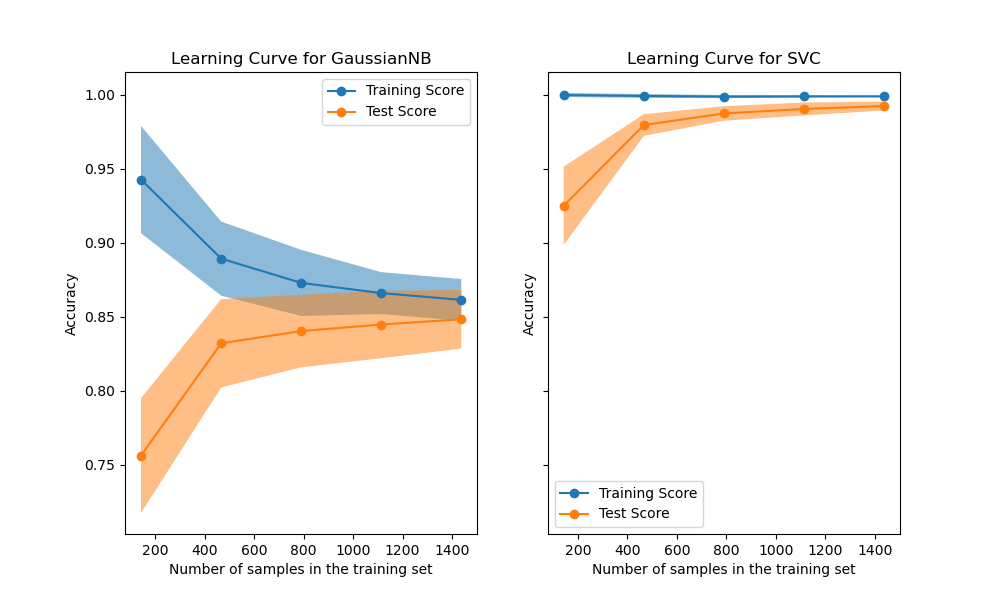
这张图用于训练阶段判断:是继续加数据、调参,还是需要换模型结构。
Step 6: 模型评估 (Model Evaluation)
训练完成后,用测试数据评估模型的效果。常见的评估指标包括 Accuracy、Precision、Recall、F1 Score 等(我们在第二章会详细讲解)。
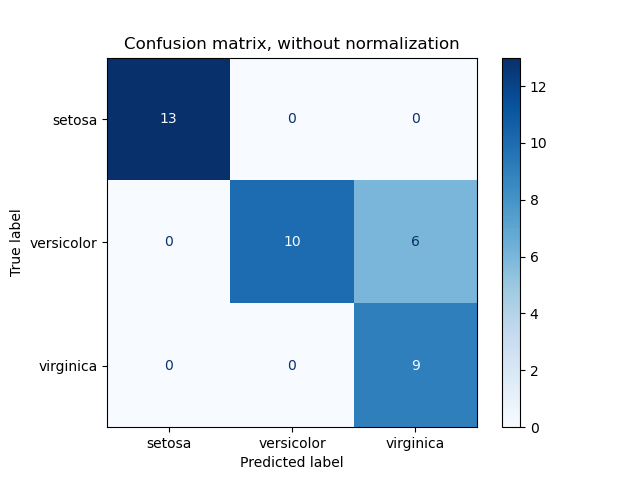
这张图能帮助你在场景题里快速区分误报和漏报,并选择更合适的评估指标。
Step 7: 部署 (Deployment)
把训练好的模型部署到生产环境中,让它接受真实数据的 Inference (推理)。
Inference (推理) 是模型在生产环境中对新数据做出预测的过程。就像学生参加考试,训练是复习阶段,推理就是考试本身。
AWS 服务: SageMaker Endpoints 提供实时推理,SageMaker Batch Transform 提供批量推理。
Step 8: 监控 (Monitoring)
模型上线后不是就结束了。数据分布会随时间变化(Model Drift),模型性能可能下降,需要持续监控和更新。
AWS 服务: Amazon SageMaker Model Monitor
⚠️ 考试重点: AWS 考试会考查你对整个生命周期的理解,尤其是"什么阶段用什么 AWS 服务"。记住这个映射关系比记住每个阶段的细节更重要。
💡 关键术语详解 (Key Terms)
这些术语是整个 AI/ML 领域的基石,考试中会反复出现。每个概念你都需要彻底搞懂。
Training Data (训练数据)
用来训练模型的数据集。它包含了模型需要学习的输入(Features)和期望的输出(Labels)。训练数据的质量和数量直接决定了模型的好坏。
常见混淆: Training Data 和 Test Data 不同。Training Data 用于学习,Test Data 用于最终评估——就像平时的练习题和期末考试的区别。
Labels (标签)
在 Supervised Learning 中,Label 就是数据的"正确答案"。比如在垃圾邮件分类中,"是垃圾邮件"或"不是垃圾邮件"就是 Label。
常见混淆: 不是所有 ML 任务都需要 Labels。Unsupervised Learning 就不需要。如果考题说"没有标注数据",那一定不是 Supervised Learning。
Features (特征)
Features 是模型用来做预测的输入变量。在预测房价的模型中,房屋面积、卧室数量、地理位置都是 Features。
好的 Features 是 ML 成功的关键。一个平庸的算法配上精心设计的 Features,往往比一个复杂的算法配上糟糕的 Features 效果更好。
Model (模型)
Model 是训练后得到的数学函数,它把输入映射到输出。你可以把它想象成一个"黑盒子"——输入 Features,输出预测结果。
Inference (推理)
Inference 是模型部署后,接收新的输入数据并给出预测的过程。这是模型创造价值的阶段。
⚠️ 考试重点: 区分 Training 和 Inference。Training 消耗大量计算资源但只做一次(或定期做),Inference 消耗较少资源但持续进行。AWS 的定价模型也反映了这一区别。
Hyperparameters (超参数)
Hyperparameters 是在训练开始之前由人工设置的配置参数,不是模型从数据中学到的。比如学习率(Learning Rate)、神经网络层数、每层神经元数量等。
比喻:Parameters(参数)是学生在学习过程中自己掌握的知识,Hyperparameters(超参数)是老师在开学前就定好的教学计划——用哪本教材、一周上几节课、每节课多长。
常见混淆: Parameters vs Hyperparameters。Parameters 是模型在训练过程中自动学到的(如权重 weights),Hyperparameters 是你手动设置的。考试可能让你区分两者。
Epoch (轮次)
一个 Epoch 是指模型把所有训练数据完整看一遍。通常训练需要多个 Epochs。就像学生把整本教材从头到尾读一遍是一个 Epoch,读三遍就是三个 Epochs。
Batch Size (批次大小)
每次训练时送入模型的数据量。如果训练数据有 10000 条,Batch Size 是 100,那么一个 Epoch 需要 100 次迭代。
⚠️ 常见错误与易混淆概念
错误 1: 认为 AI 一定需要大量数据
不是所有 AI 都需要大量数据。规则系统、专家系统等传统 AI 方法不依赖数据。但 ML 和 Deep Learning 确实需要数据,而且 Deep Learning 通常需要比传统 ML 更多的数据。
错误 2: 混淆 Classification 和 Regression
这两者最本质的区别是输出类型:
- Classification: 输出是离散类别("是/否"、"猫/狗/鸟")
- Regression: 输出是连续数值("23.5 度"、"¥350 万")
考试陷阱:如果题目问"预测客户是否会流失"——这是 Classification(是/否)。但如果问"预测客户多长时间后会流失"——这就变成了 Regression(具体天数)。
错误 3: 以为更复杂的模型一定更好
过于复杂的模型容易 Overfitting(过拟合),在训练数据上表现完美,但在新数据上表现很差。有时候简单模型反而更好,这就是奥卡姆剃刀原则在 ML 中的应用。
错误 4: 忽视数据质量
很多初学者花大量时间调模型参数,却忽略了数据本身的质量。记住一条铁律:好的数据比好的算法更重要。AWS 在多个白皮书中都强调了这一点。
错误 5: 混淆 Supervised 和 Unsupervised 的使用场景
判断技巧: 看题目中有没有提到"标签"或"历史结果"。
- 有标签数据 → Supervised Learning
- 无标签数据 + 需要发现模式 → Unsupervised Learning
- 通过试错 + 奖励信号 → Reinforcement Learning
🎯 备考路线图 (Study Roadmap)
根据考试权重和难度,建议按以下顺序学习:
第一阶段:打基础(1-2 周)
| 章节 | 内容 | 对应 Domain |
|---|---|---|
| 第 1 章 | AI/ML 基础概念(本章) | Domain 1 |
| 第 2 章 | ML 核心概念(算法、评估) | Domain 1 |
| 第 3 章 | 生成式 AI 基础 | Domain 2 |
第二阶段:重点突破(2-3 周)
| 章节 | 内容 | 对应 Domain |
|---|---|---|
| 第 4 章 | AWS AI/ML 服务 | Domain 1 & 3 |
| 第 5 章 | Amazon Bedrock 与基础模型 | Domain 3 |
| 第 6 章 | RAG 与 Agent 架构 | Domain 3 |
| 第 7 章 | Prompt Engineering 进阶 | Domain 2 & 3 |
第三阶段:合规与安全(1 周)
| 章节 | 内容 | 对应 Domain |
|---|---|---|
| 第 8 章 | 负责任 AI 实践 | Domain 4 |
| 第 9 章 | AI 安全与合规 | Domain 5 |
第四阶段:模考冲刺(1 周)
- 完成至少 3 套模拟考试
- 重点复习错题涉及的知识点
- 考前重温 Domain 2 和 Domain 3 的内容
💡 学习建议: 不要试图一次记住所有内容。每学完一章,用自己的话复述核心概念。如果你能向一个不懂技术的朋友解释清楚,说明你真正理解了。
📚 本章小结
本章是整个 AIF-C01 认证备考的起点,我们覆盖了以下核心知识点:
- 考试概况: AIF-C01 共 65 题,90 分钟,700/1000 通过,$75 报名费
- 五大考试领域: Domain 3(基础模型应用,28%)和 Domain 2(生成式 AI,24%)是重中之重
- AI vs ML vs DL: 三者是嵌套关系,AI 最广,ML 是 AI 子集,DL 是 ML 子集
- ML 三大类型: Supervised(有标签)、Unsupervised(无标签)、Reinforcement(奖惩信号)
- ML 生命周期: 问题定义 → 数据收集 → 数据准备 → 特征工程 → 训练 → 评估 → 部署 → 监控
- 关键术语: Training Data、Labels、Features、Model、Inference、Hyperparameters、Epoch、Batch Size
下一章预告: 我们将深入 ML 的核心概念——具体的算法、模型评估指标、过拟合与欠拟合等。这些概念在考试中会以场景题的形式出现,需要你能灵活运用。