
📖 机器学习核心概念 (ML Core Concepts)
上一章我们了解了 ML 的三大类型和整体框架。这一章我们要深入核心:具体的算法长什么样?怎么判断一个模型好不好?什么是过拟合?这些问题在 AIF-C01 考试中非常高频,而且往往以场景题的形式出现。
本章属于 Domain 1: Fundamentals of AI and ML(20%),和第一章共同构成了你理解整个 AI/ML 领域的基石。
🎯 监督学习算法详解 (Supervised Learning Algorithms)
考试不会要求你手写算法公式,但你需要理解每种算法的核心思路、适用场景,以及它们之间的区别。这些知识在考试的场景题中至关重要。
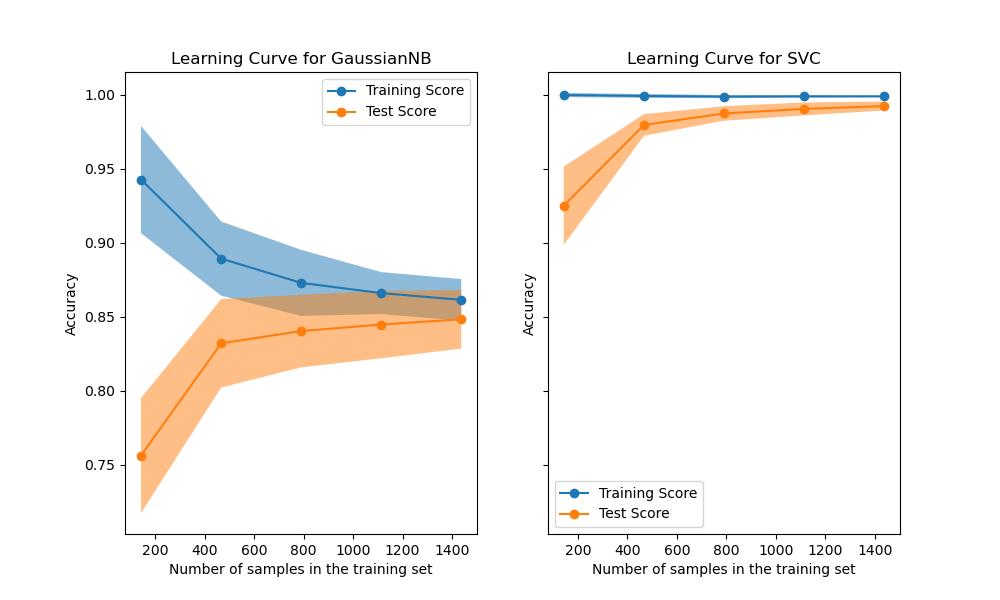
这张图放在前半部分用于建立“模型是否学到规律”的直觉:考试给到训练/验证表现差异时,可以更快判断问题方向。
Linear Regression (线性回归)
Linear Regression 是最简单的监督学习算法,用于预测连续数值。它的核心假设是:输入和输出之间存在线性关系。
比喻:就像画一条"最佳拟合线"穿过一堆散点。如果你看到一张图上有很多点,Linear Regression 做的就是找到一条直线,让所有点到这条线的距离之和最小。
y = wx + b

y: 预测值(如房价)
x: 输入特征(如面积)
w: 权重(斜率,模型学到的)
b: 偏置(截距,模型学到的)
适用场景: 房价预测、销售额预测、温度预测等连续数值预测。 局限性: 只能处理线性关系。如果数据的关系是弯曲的(非线性),它的表现就会很差。
⚠️ 考试重点: 看到"预测一个连续数值"且数据关系比较简单时,Linear Regression 是首选。如果题目提到"非线性关系",就不该选它。
Logistic Regression (逻辑回归)
虽然名字里有"Regression",但 Logistic Regression 实际上是一个 Classification (分类) 算法。这是考试中经典的混淆点。
它通过 Sigmoid 函数把任意数值映射到 0 和 1 之间,输出一个"概率值"。如果概率大于 0.5,分类为正例;否则分类为反例。
比喻:想象一个翻译器,它把"考试分数"翻译成"通过/不通过的概率"。不管你考了 30 分还是 90 分,输出的概率始终在 0% 到 100% 之间。
适用场景: 邮件分类(垃圾/正常)、客户流失预测(是/否)、疾病诊断(阳性/阴性)。 局限性: 只适合线性可分的问题,对于复杂的非线性决策边界效果不好。
常见混淆: Logistic Regression 是分类算法,不是回归算法!考试可能故意用名字来混淆你。
Decision Tree (决策树)
Decision Tree 通过一系列 if-else 条件把数据不断拆分,最终形成一棵"树"结构。每个内部节点是一个判断条件,每个叶子节点是一个预测结果。
比喻:就像你玩"20 个问题"猜物游戏。"它是活的吗?""它比人大吗?""它在水里生活吗?"通过一系列问题逐步缩小范围,最终猜中答案。
                  [年收入 > 50万?]
                  /              \
               是 /                \ 否
        [信用评分 > 700?]      [有房产?]
         /          \           /      \
       是 /          \ 否      是 /      \ 否
    [批准贷款]  [需要审核]  [小额批准] [拒绝]
优点: 结果可解释性强,不需要数据标准化,能处理非线性关系。 缺点: 容易过拟合,对数据的小变化很敏感。
⚠️ 考试重点: 当题目强调"模型可解释性"(Explainability/Interpretability) 时,Decision Tree 是首选。这在 Responsible AI 场景中特别重要。
Random Forest (随机森林)
Random Forest 是 Decision Tree 的升级版,它训练多棵决策树,然后让它们"投票"决定最终结果。这种"集体智慧"的方法叫做 Ensemble Learning (集成学习)。
比喻:一个人做决策容易出错(单棵决策树),但如果你找 100 个专家各自独立判断,然后取多数人的意见,结果通常更靠谱。这就是 Random Forest 的精髓。
核心机制:
- Bagging (Bootstrap Aggregating): 每棵树用随机抽取的数据子集训练
- Feature Randomness: 每棵树在每个分裂点只考虑随机选取的部分特征
- Voting/Averaging: 最终结果由所有树投票(分类)或取平均(回归)
优点: 比单棵 Decision Tree 更稳定,不容易过拟合,精度通常更高。 缺点: 训练时间较长,可解释性不如单棵 Decision Tree。
Neural Networks (神经网络)
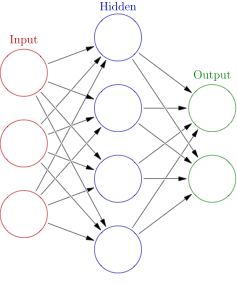
Neural Network 由多层互相连接的节点(Neurons)组成,灵感来源于人脑神经元的工作方式。它是 Deep Learning 的基础。
比喻:想象一个工厂的流水线。原材料(输入数据)进入第一条生产线(Input Layer),经过多条中间生产线的加工处理(Hidden Layers),最终产出成品(Output Layer)。每条生产线上的工人决定如何处理和传递信息。
Input Layer      Hidden Layers       Output Layer
   (O)
   (O) ----→     (O) (O)
   (O) ----→     (O) (O) ----→       (O) 预测结果
   (O) ----→     (O) (O)
   (O)
 输入特征        中间处理             最终输出
核心概念:
- Neuron (神经元): 基本计算单元,接收输入,加权求和,通过激活函数输出
- Weights (权重): 连接强度,模型训练时自动调整
- Activation Function (激活函数): 引入非线性,让网络能学习复杂模式(ReLU、Sigmoid、Tanh)
- Backpropagation (反向传播): 模型学习的核心机制,根据误差从后往前调整权重
适用场景: 图像识别、语音识别、自然语言处理等复杂任务。 缺点: 需要大量数据和计算资源,可解释性差(被称为"黑盒子")。
⚠️ 考试重点: 当题目提到"复杂模式识别"、"大量数据"、"非结构化数据(图像、文本、音频)"时,Neural Network / Deep Learning 通常是正确答案。但如果强调"可解释性",则应选择 Decision Tree 或 Linear/Logistic Regression。
监督学习算法对比总结
| 算法 | 任务类型 | 数据要求 | 可解释性 | 适用场景 |
|---|---|---|---|---|
| Linear Regression | 回归 | 少量即可 | 高 | 简单数值预测 |
| Logistic Regression | 分类 | 中等 | 高 | 二分类问题 |
| Decision Tree | 分类/回归 | 中等 | 很高 | 需要解释性的场景 |
| Random Forest | 分类/回归 | 中等 | 中等 | 通用、高精度 |
| Neural Network | 分类/回归 | 大量 | 低 | 复杂模式识别 |
🎯 无监督学习算法详解 (Unsupervised Learning Algorithms)
K-Means Clustering (K-均值聚类)
K-Means 是最经典的聚类算法,目标是把 N 个数据点分成 K 个组(Cluster),让每个组内的数据点尽可能相似,组间差异尽可能大。
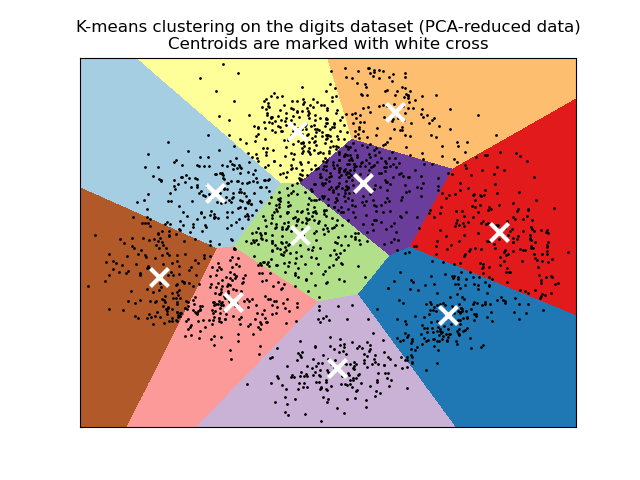
这张图用于理解“无标签分组”考点:题干出现客户分群/用户分层时,通常对应聚类思路。
比喻:假设你是一个外卖平台的运营,需要在城市里设 3 个配送站。你会怎么选位置?直觉上,你会把配送站放在订单最密集的 3 个区域的"中心点"。K-Means 做的就是这件事——找到 K 个最优的"中心点"。
算法步骤:
- 随机选择 K 个初始中心点
- 把每个数据点分配到离它最近的中心点
- 重新计算每个组的中心点
- 重复步骤 2-3,直到中心点不再变化
关键问题:K 怎么选?
- Elbow Method (肘部法则): 画出不同 K 值对应的误差曲线,找到曲线开始"拐弯"的点
- Silhouette Score: 衡量聚类质量的指标,越接近 1 越好
适用场景: 客户分群、市场细分、图像压缩。
⚠️ 考试重点: K-Means 需要你预先指定 K 值(聚类数量)。如果题目问"自动确定最佳聚类数",需要结合 Elbow Method。
PCA (Principal Component Analysis,主成分分析)
PCA 是一种 Dimensionality Reduction (降维) 技术。它把高维数据投影到低维空间,同时尽量保留数据中最重要的信息。
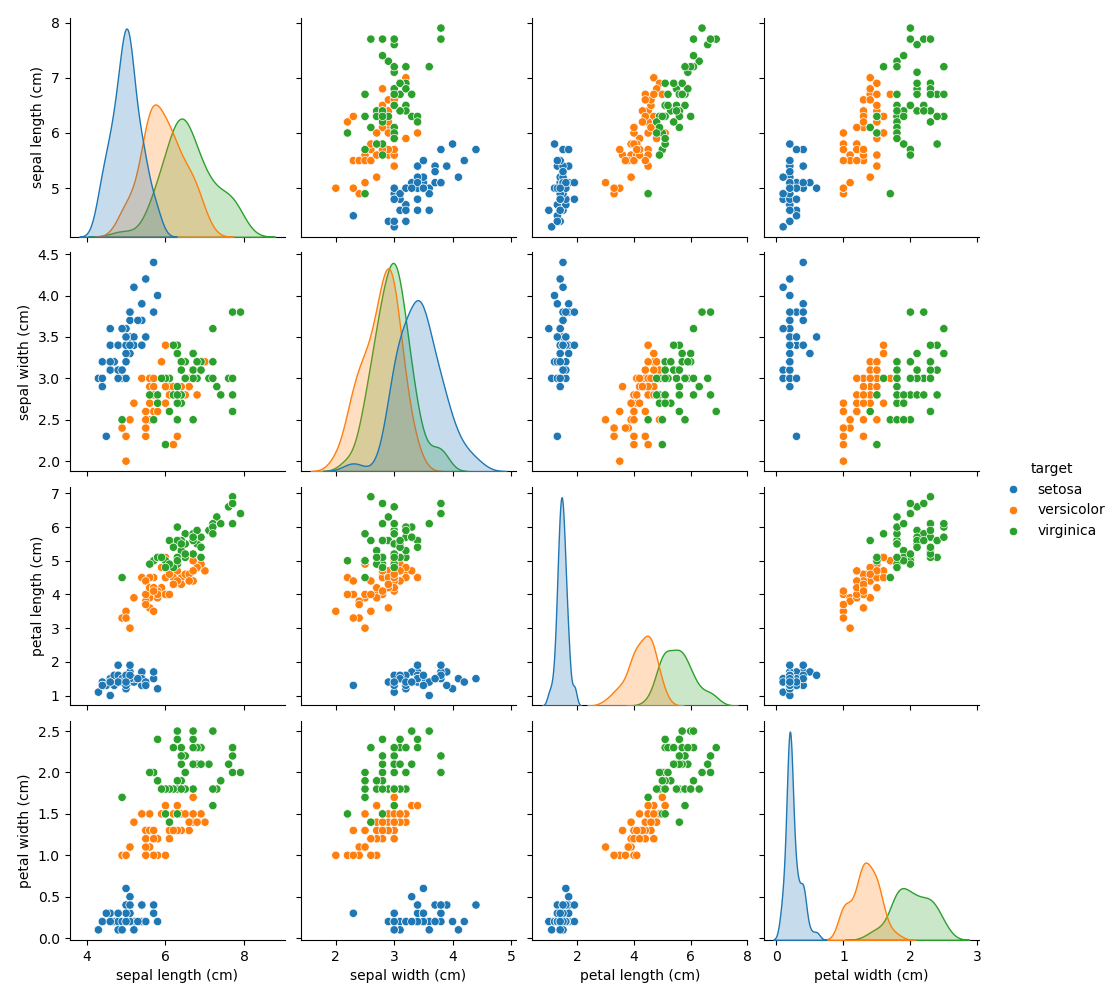
这张图用于直观理解“降维后仍保留类别结构”的核心思想,适合应对 PCA 场景题。
比喻:假设你有一张 3D 照片,但你需要打印在 2D 纸上。PCA 做的就是找到最好的"拍摄角度",让 2D 照片尽可能保留 3D 场景的主要信息。有些角度拍出来几乎看不出区别,有些角度则会丢失很多细节。PCA 帮你找到最佳角度。
- 维度灾难 (Curse of Dimensionality): 特征越多,需要的训练数据呈指数增长
- 减少计算成本: 更少的特征意味着更快的训练速度
- 去除噪声: 去掉不重要的特征可以提高模型性能
- 数据可视化: 人类只能可视化 2D 或 3D 数据
适用场景: 数据预处理、特征压缩、去噪、可视化高维数据。
💡 特征工程:为什么你应该花最多时间在这里?
为什么需要特征工程?
Feature Engineering (特征工程) 是从原始数据中提取、转换、创建有意义的输入变量的过程。这是 ML 项目中最影响最终效果的环节——一个好的特征能让简单的模型打败复杂的模型。
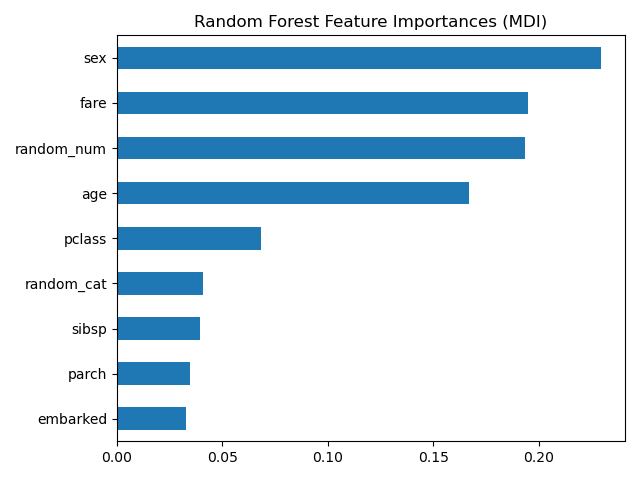
这张图帮助记忆“先做特征再调模型”的考点:考试问如何提升效果时,特征重要性分析通常是高性价比选项。
有一句业内名言:"Applied machine learning is basically feature engineering."——Andrew Ng。这不是夸张,在很多实际项目中,花 70% 的时间在特征工程上比花 70% 时间调模型参数效果好得多。
常见特征工程技术
Normalization / Standardization (归一化/标准化)
把不同量级的特征缩放到同一范围,防止大数值的特征"压制"小数值的特征。
举例:预测房价时,面积的值可能是 50-200(平方米),而卧室数量只有 1-5。如果不做归一化,模型会认为面积比卧室数量"重要"得多,仅仅因为它的数值更大。
- Min-Max Normalization: 把数据缩放到 [0, 1] 区间
- Z-Score Standardization: 把数据转换为均值为 0、标准差为 1 的分布
One-Hot Encoding (独热编码)
把分类变量转换成数值形式。ML 模型只认数字,不认文字。
原始数据:        One-Hot 编码后:
颜色              红  绿  蓝
──────            ──────────
红                1   0   0
绿                0   1   0
蓝                0   0   1
红                1   0   0
常见混淆: 为什么不直接用 1、2、3 表示红、绿、蓝?因为这样模型会认为"蓝(3) > 绿(2) > 红(1)",引入了不存在的顺序关系。One-Hot Encoding 避免了这个问题。
Label Encoding (标签编码)
对于有序分类变量(如"低/中/高"),可以用数字编码:低=1,中=2,高=3。这里的顺序关系是真实存在的,所以不需要 One-Hot。
Feature Selection (特征选择)
不是所有特征都有用。有些特征可能是噪声,甚至会降低模型性能。Feature Selection 就是挑选出最有价值的特征。
常用方法:
- Correlation Analysis: 去掉和目标变量相关性很低的特征
- Feature Importance: 用 Random Forest 等模型计算每个特征的重要性
- Domain Knowledge: 利用业务知识判断哪些特征有意义
⚠️ 考试重点: 考试可能问"如何提高模型性能"。特征工程往往是最有效的方式,而不是换一个更复杂的算法。
💡 数据预处理:处理现实世界的"脏数据"
现实世界的数据几乎不可能是干净完美的。数据预处理是把"脏数据"变成模型可用的"干净数据"的过程。
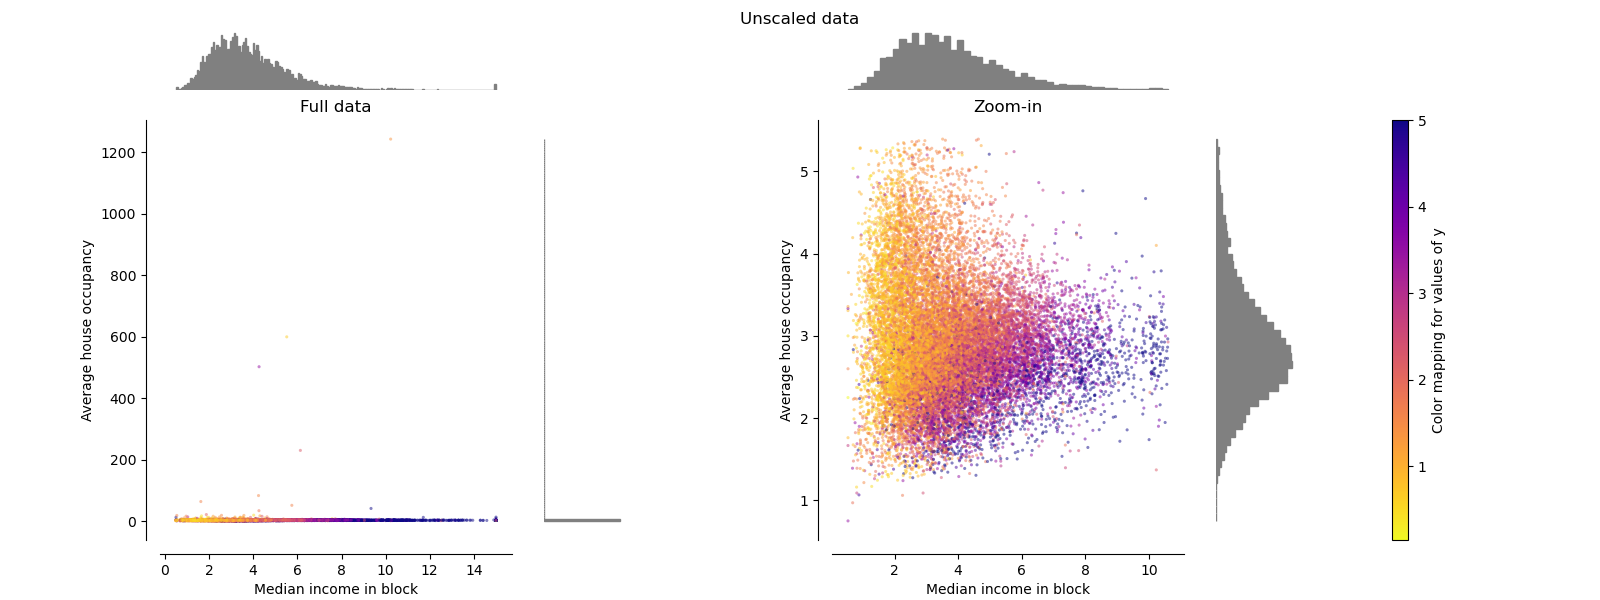
这张图用于前半段快速补齐可视化:标准化/归一化不是背定义,关键是理解不同数据分布下的处理效果差异。
处理 Missing Values (缺失值)
数据中总会有缺失值——用户没填的字段、传感器故障等。处理方式取决于缺失的原因和比例:
| 方法 | 说明 | 适用场景 |
|---|---|---|
| 删除行 | 去掉有缺失值的数据 | 缺失比例很小(<5%)且随机缺失 |
| 均值/中位数填充 | 用该列的平均值或中位数填充 | 数值型特征,缺失比例中等 |
| 众数填充 | 用出现次数最多的值填充 | 分类型特征 |
| 插值法 | 用周围数据估算缺失值 | 时间序列数据 |
| 模型预测 | 用其他特征训练模型预测缺失值 | 复杂场景 |
处理 Outliers (异常值)
Outlier (异常值) 是明显偏离其他数据点的值。比如一个班级的成绩中,大部分人 70-90 分,但有一个人 5 分——这就是异常值。
处理方式:
- 了解原因: 是数据错误还是真实的极端情况?
- IQR 方法: 用四分位距识别异常值(低于 Q1-1.5IQR 或高于 Q3+1.5IQR)
- Z-Score 方法: 偏离均值超过 3 个标准差的视为异常值
- 不一定要删除: 有时异常值本身就是你要找的(比如欺诈检测)
处理 Imbalanced Datasets (不平衡数据集)
Imbalanced Dataset 是指不同类别的样本数量差异很大的数据集。这在现实中非常常见。
举例:欺诈检测中,99.9% 的交易是正常的,只有 0.1% 是欺诈。如果模型简单地把所有交易都预测为"正常",准确率就有 99.9%——但它完全没有识别欺诈的能力。
解决方法:
| 方法 | 说明 |
|---|---|
| Oversampling (过采样) | 增加少数类的样本数量(如 SMOTE 算法) |
| Undersampling (欠采样) | 减少多数类的样本数量 |
| Class Weights (类别权重) | 让模型对少数类的错误给予更大的惩罚 |
| 不用 Accuracy: | 改用 Precision、Recall、F1 等指标来评估 |
⚠️ 考试重点: 当题目描述一个不平衡数据集时,考试通常会考你两件事:(1) 不应该用 Accuracy 作为评估指标 (2) 应该用什么方法处理不平衡。SMOTE 和 Class Weights 是最常见的答案。
🎯 模型评估指标:如何判断模型好不好?
这一节是考试的绝对高频考点。你不仅需要理解每个指标的含义,还需要知道在什么场景下用什么指标。
Confusion Matrix (混淆矩阵)
Confusion Matrix 是理解所有分类指标的基础。它是一个 2x2 的表格(对于二分类),展示了模型预测结果和真实结果的四种组合。
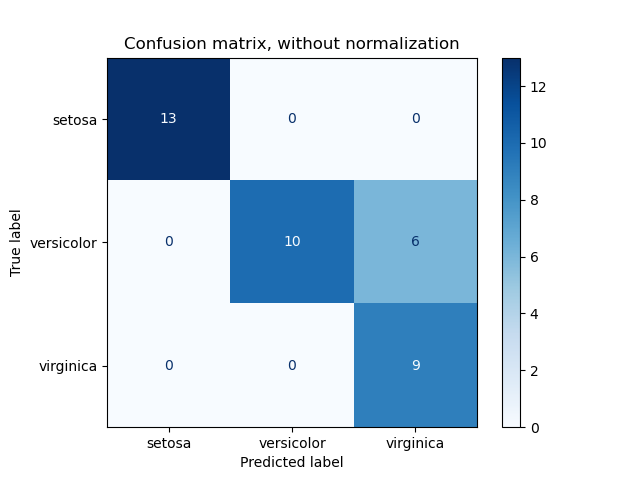
这张图能帮助你在考试里快速定位 TP/FP/FN/TN,不容易把“误报”和“漏报”混淆。
                    模型预测
                 Positive  Negative
真   Positive  │   TP    │   FN    │
实              ├─────────┼─────────┤
结   Negative  │   FP    │   TN    │
果              └─────────┴─────────┘
用一个具体例子来理解——新冠检测:
| 术语 | 含义 | 新冠检测的例子 |
|---|---|---|
| TP (True Positive) | 预测阳性,实际也是阳性 | 感染者被正确检测出来 |
| TN (True Negative) | 预测阴性,实际也是阴性 | 健康人被正确排除 |
| FP (False Positive) | 预测阳性,实际是阴性 | 健康人被误诊为感染("误报") |
| FN (False Negative) | 预测阴性,实际是阳性 | 感染者被漏检("漏报") |
记忆技巧:
- 第一个字母 True/False = 预测是否正确
- 第二个字母 Positive/Negative = 模型预测的类别
⚠️ 考试重点: FP 和 FN 的实际影响在不同场景中完全不同。在医疗检测中,FN(漏检)比 FP(误诊)严重得多。在垃圾邮件过滤中,FP(正常邮件被标记为垃圾)可能比 FN(垃圾邮件漏网)更让用户恼火。考试会根据场景让你选择优先降低 FP 还是 FN。
Accuracy (准确率)
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Accuracy 是最直观的指标:在所有预测中,有多少比例预测正确了?
局限性: 在 Imbalanced Dataset 中,Accuracy 是具有欺骗性的。如果 99% 的数据都是负例,一个"全部预测为负"的模型也有 99% 的 Accuracy,但它完全没用。
Precision (精确率)
Precision = TP / (TP + FP)
在所有"模型预测为 Positive"的结果中,有多少是真正的 Positive?
比喻:就像一个法官,Precision 高意味着他判定有罪的人中,确实有罪的比例很高——宁可放过,不能冤枉。
适用场景: 当 FP(误报)的代价很高时,你应该优化 Precision。
- 垃圾邮件过滤:把正常邮件标记为垃圾(FP)会让用户错过重要邮件
- 推荐系统:推荐不相关的内容(FP)会影响用户体验
Recall (召回率 / 灵敏度)
Recall = TP / (TP + FN)
在所有"实际为 Positive"的数据中,模型正确找出了多少?
比喻:就像一个安检人员,Recall 高意味着所有有问题的人都被拦截了——宁可多检查,不能放过。
适用场景: 当 FN(漏报)的代价很高时,你应该优化 Recall。
- 癌症筛查:漏诊一个癌症患者(FN)可能致命
- 欺诈检测:漏掉一笔欺诈交易(FN)会造成直接损失
F1 Score
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1 Score 是 Precision 和 Recall 的调和平均值。当你需要在两者之间取平衡时,F1 是一个综合指标。
关键特点: F1 Score 对较低的那个指标更敏感。如果 Precision=0.95 但 Recall=0.10,F1 只有 0.18——它不会被一个高值"拉上去"。
适用场景: 当 Precision 和 Recall 同样重要,或者你不确定该优化哪个时。
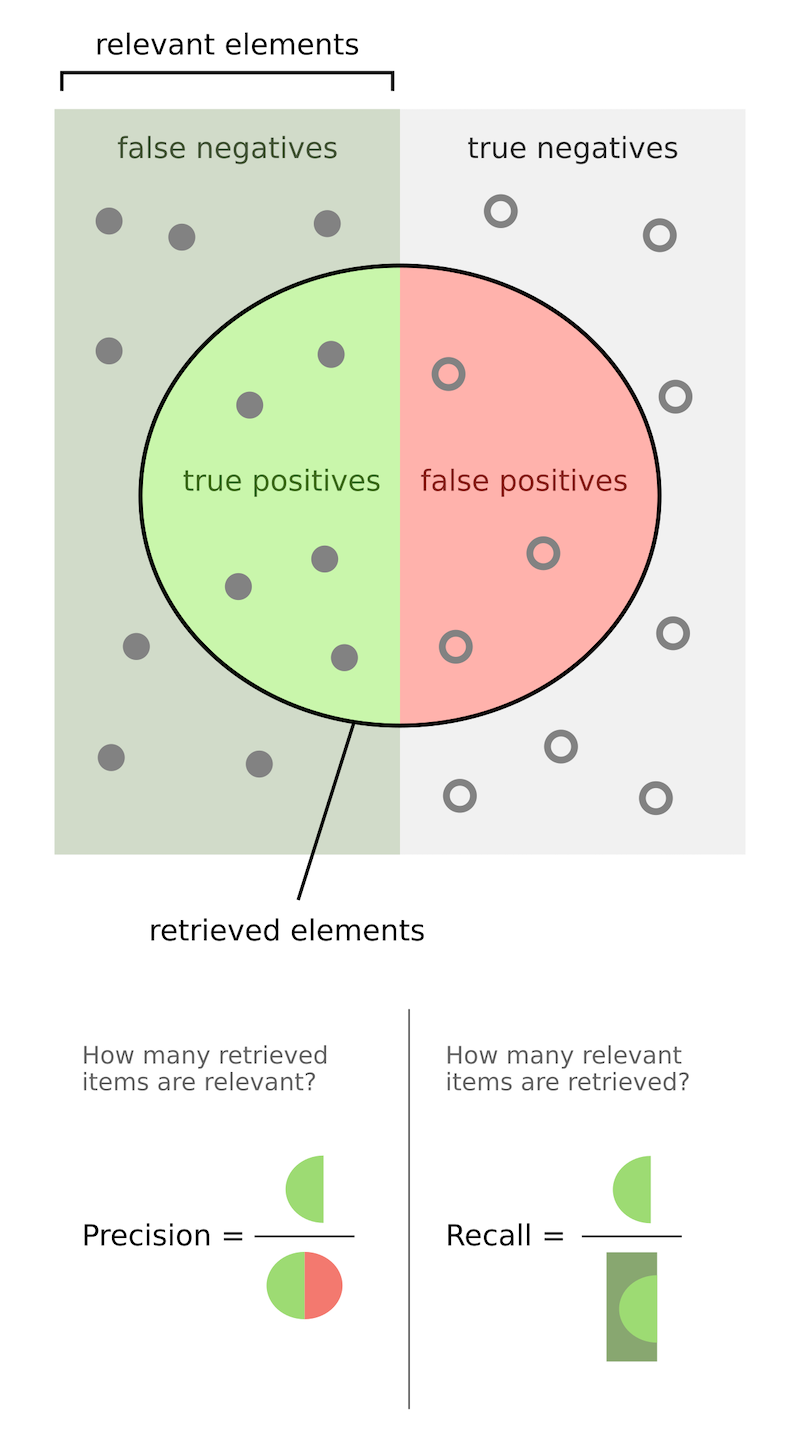
这张图用于做题时快速判断指标取舍:如果业务更怕漏报,优先看高 Recall 区域;如果更怕误报,优先看高 Precision 区域。
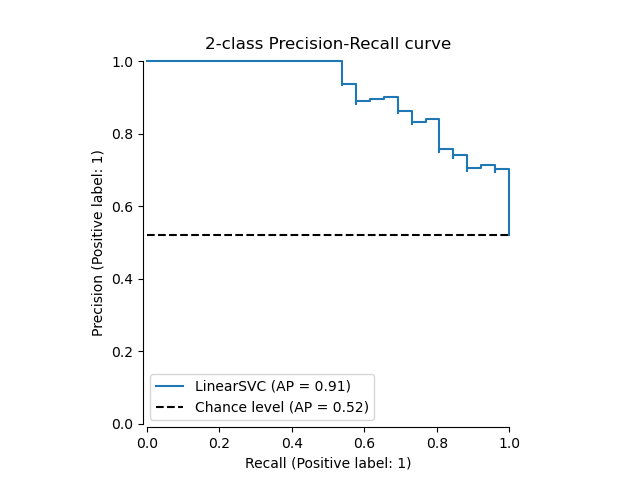
这张图用于强化阈值变化直觉:阈值变动会让 Precision 与 Recall 此消彼长,适合场景题判断。
AUC-ROC
ROC (Receiver Operating Characteristic) 曲线展示了不同分类阈值下,True Positive Rate 和 False Positive Rate 的关系。AUC (Area Under the Curve) 是 ROC 曲线下的面积。
- AUC = 1.0: 完美模型
- AUC = 0.5: 和随机猜测一样差
- AUC < 0.5: 比随机猜测还差(说明你的标签搞反了)
适用场景: 当你需要一个不受分类阈值影响的、综合评估模型能力的指标时。特别适合比较不同模型的整体表现。
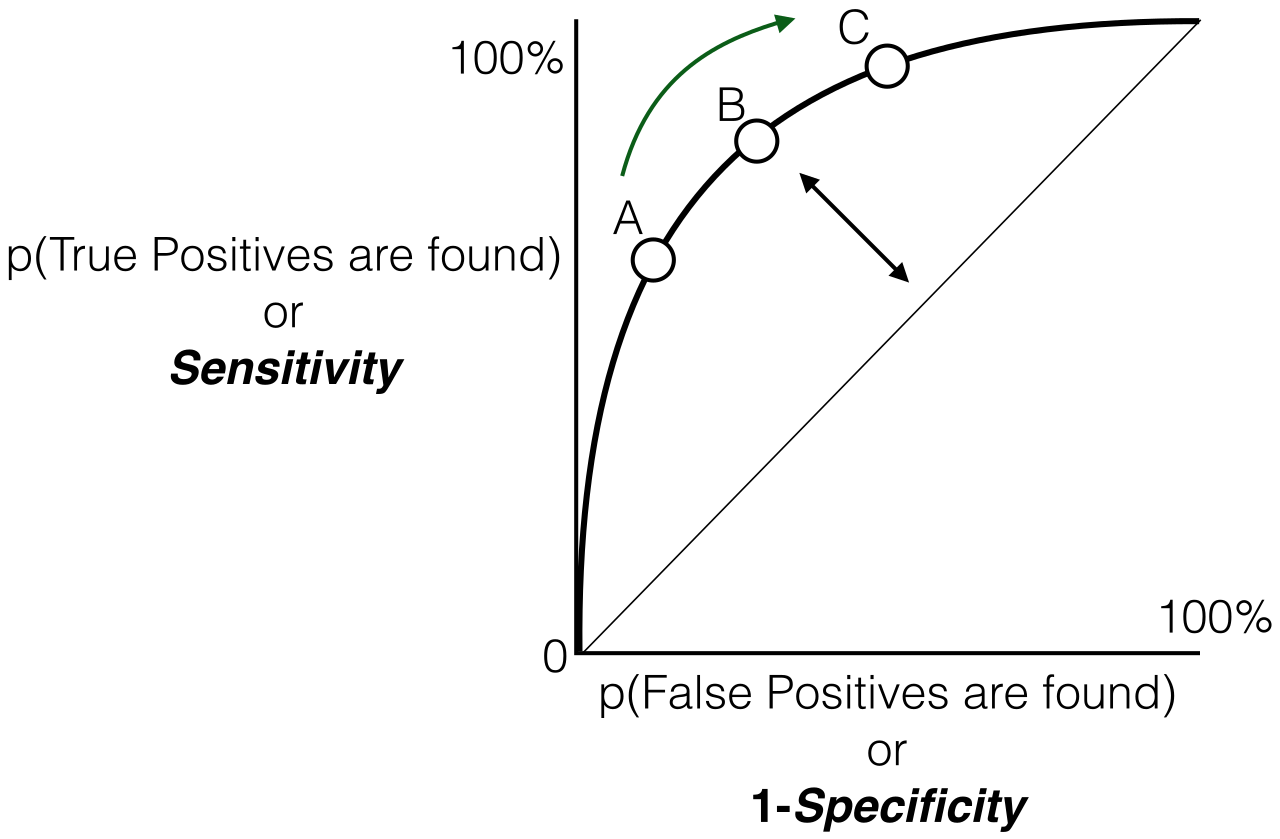
这张图对应 AUC-ROC 高频题:曲线越靠左上、AUC 越大,模型整体区分能力通常越强。
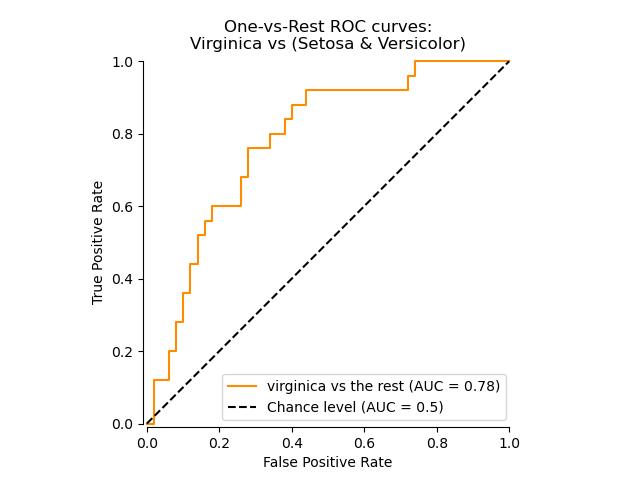
这张图用于对比模型优劣:同场景下曲线更靠左上通常代表更好的分类能力。
指标选择速查表
| 场景 | 推荐指标 | 原因 |
|---|---|---|
| 数据平衡,通用评估 | Accuracy | 直观简单 |
| 数据不平衡 | F1 Score / AUC-ROC | Accuracy 不可靠 |
| 误报代价高(如垃圾邮件过滤) | Precision | 减少 FP |
| 漏报代价高(如疾病检测) | Recall | 减少 FN |
| 比较多个模型 | AUC-ROC | 不受阈值影响 |
| Precision 和 Recall 都重要 | F1 Score | 综合平衡 |
⚠️ 考试重点: 这张表几乎是必考内容。考试会给你一个具体场景,让你选择最合适的评估指标。关键是判断"误报和漏报,哪个代价更高"。
💡 过拟合与欠拟合:模型表现的两个极端
Overfitting (过拟合)
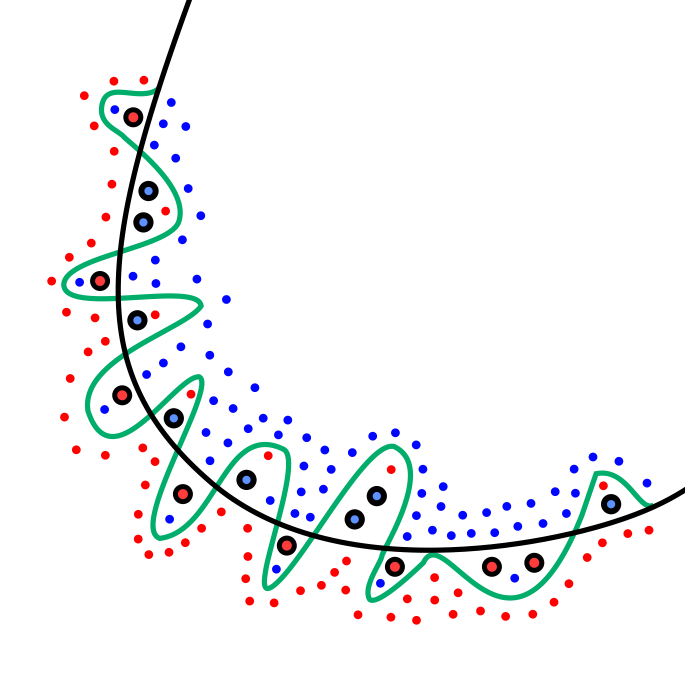
Overfitting 是指模型把训练数据"背"得太好了,连其中的噪声和随机波动都学进去了,导致它在新数据上表现很差。
比喻:就像一个学生只会做原题,不会举一反三。他把练习题的答案全部背下来了,考试遇到同样的题满分,但稍微换个数字就不会做了。这就是"死记硬背"型学习。
Overfitting 的信号:
- 训练集上表现非常好(准确率接近 100%)
- 测试集上表现明显下降
- 训练误差 << 测试误差
如何解决 Overfitting:
- 增加训练数据: 更多数据能帮助模型学到真正的规律,而不是噪声
- Regularization (正则化): L1 (Lasso)、L2 (Ridge) 正则化,给模型复杂度加"罚分"
- Dropout: 在 Neural Network 中随机关闭部分神经元,防止依赖特定路径
- Early Stopping (早停): 当验证集误差开始上升时,停止训练
- 简化模型: 减少特征数量或降低模型复杂度
- Cross-Validation: 多次验证,确保模型不是只在特定数据划分上表现好
Underfitting (欠拟合)
Underfitting 是指模型太简单了,连训练数据中的基本规律都没学会。
比喻:就像让一个小学生做高中数学题。不是他不努力,而是他的"能力"(模型复杂度)还不够理解这些复杂的规律。
Underfitting 的信号:
- 训练集上表现就不好
- 测试集上表现也不好
- 训练误差 ≈ 测试误差(但都很高)
如何解决 Underfitting:
- 增加模型复杂度: 用更强大的模型(如从 Linear Regression 换到 Neural Network)
- 增加特征: 更多有意义的特征帮助模型捕捉规律
- 减少正则化: 正则化可能过度限制了模型
- 训练更长时间: 增加 Epochs
Overfitting vs Underfitting 对比
模型表现
    │
    │  ★ 过拟合区域           ★ 最佳平衡点          ★ 欠拟合区域
    │
    │  训练误差: 很低           训练误差: 低            训练误差: 高
    │  测试误差: 很高           测试误差: 低            测试误差: 高
    │  差距: 大                 差距: 小                差距: 小
    │
    │  模型太复杂               模型刚好                模型太简单
    └──────────────────────────────────────────────────→ 模型复杂度
⚠️ 考试重点: 考试会描述一个模型的训练和测试表现,让你判断是过拟合还是欠拟合。记住核心判断标准:训练好 + 测试差 = 过拟合;两个都差 = 欠拟合。
🎯 Bias-Variance Tradeoff (偏差-方差权衡)
Bias-Variance Tradeoff 是机器学习中最重要的理论概念之一,它解释了为什么我们不能同时让模型完美地拟合数据又完美地泛化到新数据。
什么是 Bias (偏差)?
Bias 衡量的是模型的预测值和真实值之间的系统性偏离。高 Bias 意味着模型做了过多的简化假设,导致 Underfitting。
比喻:一个总是偏高估计体重的秤,不管你称什么都多 5 公斤——这就是高 Bias。
什么是 Variance (方差)?
Variance 衡量的是模型对训练数据变化的敏感程度。高 Variance 意味着模型过度依赖特定的训练数据,换一批数据就得出完全不同的结果,导致 Overfitting。
比喻:一个极其敏感的秤,每次称同一个东西显示的数字都不同——这就是高 Variance。
Tradeoff 关系
总误差 = Bias² + Variance + 不可约误差

    误差
     │  \  Bias²
     │   \
     │    \        / Variance
     │     \      /
     │      \    /
     │       \/──── 总误差最低点(最佳平衡)
     │       /\
     │      /  \
     └──────────────→ 模型复杂度
         简单          复杂
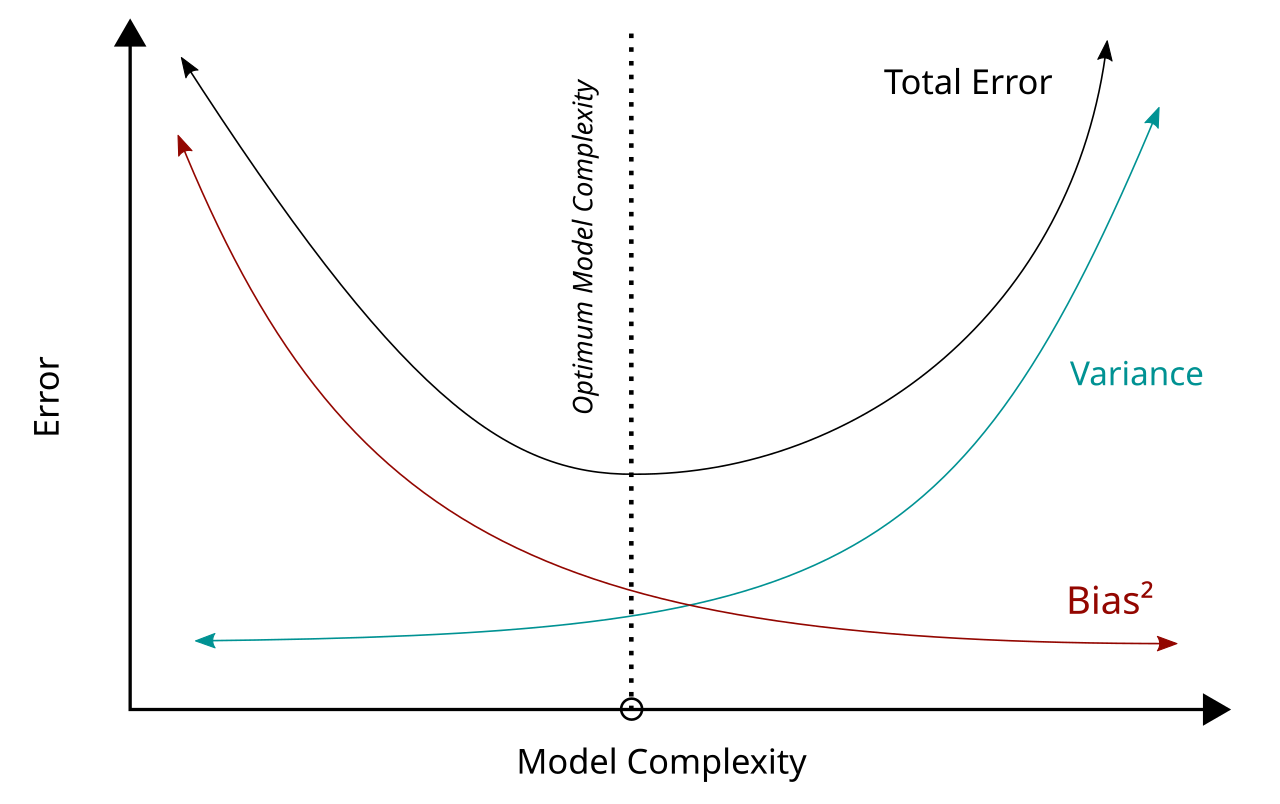
这张图能帮助你秒答场景题:模型太简单通常是高 Bias,模型太复杂通常是高 Variance,最优点在两者平衡处。
| 模型特征 | Bias | Variance | 表现 |
|---|---|---|---|
| 太简单 | 高 | 低 | Underfitting |
| 太复杂 | 低 | 高 | Overfitting |
| 刚好 | 中等 | 中等 | 最佳泛化 |
不可约误差 (Irreducible Error): 数据本身的噪声导致的误差,无论模型多好都无法消除。
💡 数据集划分:Train / Validation / Test
为什么不能用全部数据来训练模型?因为你需要留一部分"没见过的"数据来客观评估模型。这就像考试出题不能全从课堂练习里选——否则你无法判断学生是真懂了还是只是背了答案。
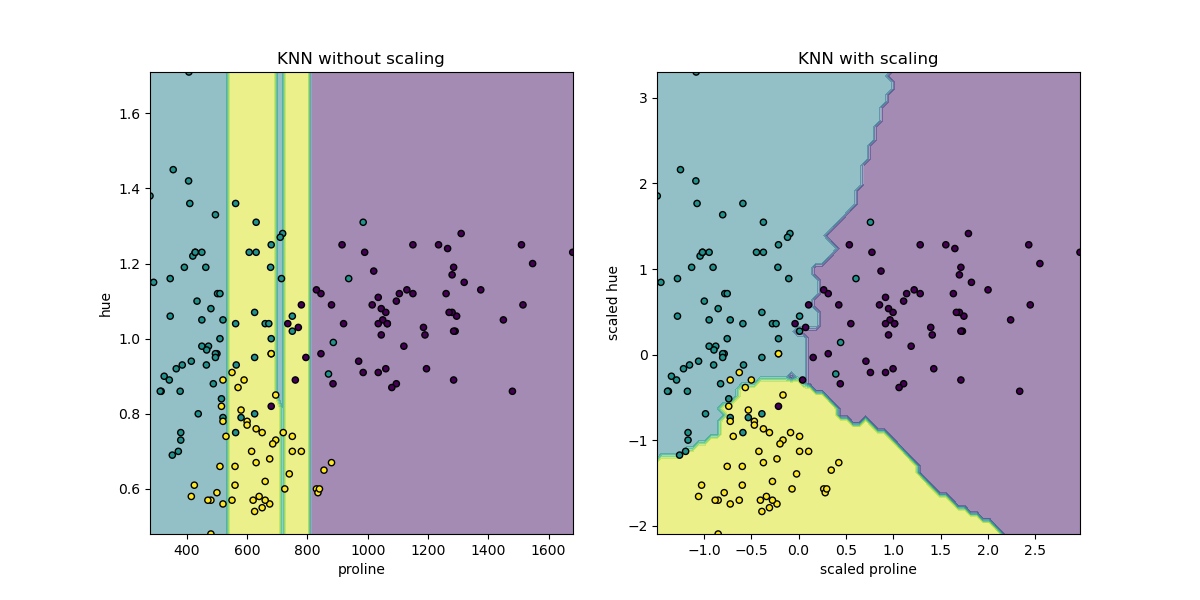
这张图放在数据划分前后,帮助理解“同样的数据,不同预处理会影响评估结果”。
三种数据集的角色
| 数据集 | 比例 | 用途 | 比喻 |
|---|---|---|---|
| Training Set | 60-80% | 训练模型 | 课堂学习 |
| Validation Set | 10-20% | 调参、选模型 | 模拟考试 |
| Test Set | 10-20% | 最终评估 | 正式考试 |
关键原则:
- Training Set 用来学习
- Validation Set 用来调整 Hyperparameters 和选择最佳模型
- Test Set 只在最后用一次,用于报告模型的最终性能
常见错误: 用 Test Set 来调参。这会导致模型间接"看到"了测试数据,评估结果不再客观。这叫做 Data Leakage (数据泄漏)。
⚠️ 考试重点: 如果考试问"为什么不能用测试集来选择最优模型",答案是 Data Leakage——模型间接适应了测试集,导致评估结果过于乐观。
🎯 Cross-Validation (交叉验证)
Cross-Validation 解决了一个实际问题:数据集比较小的时候,单次划分训练集和验证集可能不够可靠——也许你碰巧把"容易的"数据分到了测试集。
K-Fold Cross-Validation
最常用的交叉验证方法。把数据分成 K 份(通常 K=5 或 K=10),每次用其中 1 份做验证,其余 K-1 份做训练,重复 K 次,取平均结果。
5-Fold Cross-Validation:

第 1 轮: [验证] [训练] [训练] [训练] [训练]
第 2 轮: [训练] [验证] [训练] [训练] [训练]
第 3 轮: [训练] [训练] [验证] [训练] [训练]
第 4 轮: [训练] [训练] [训练] [验证] [训练]
第 5 轮: [训练] [训练] [训练] [训练] [验证]

最终结果 = 5 轮验证结果的平均值
优点: 每条数据都做过训练数据和验证数据,评估更稳定可靠,充分利用了数据。 缺点: 计算量是单次划分的 K 倍。
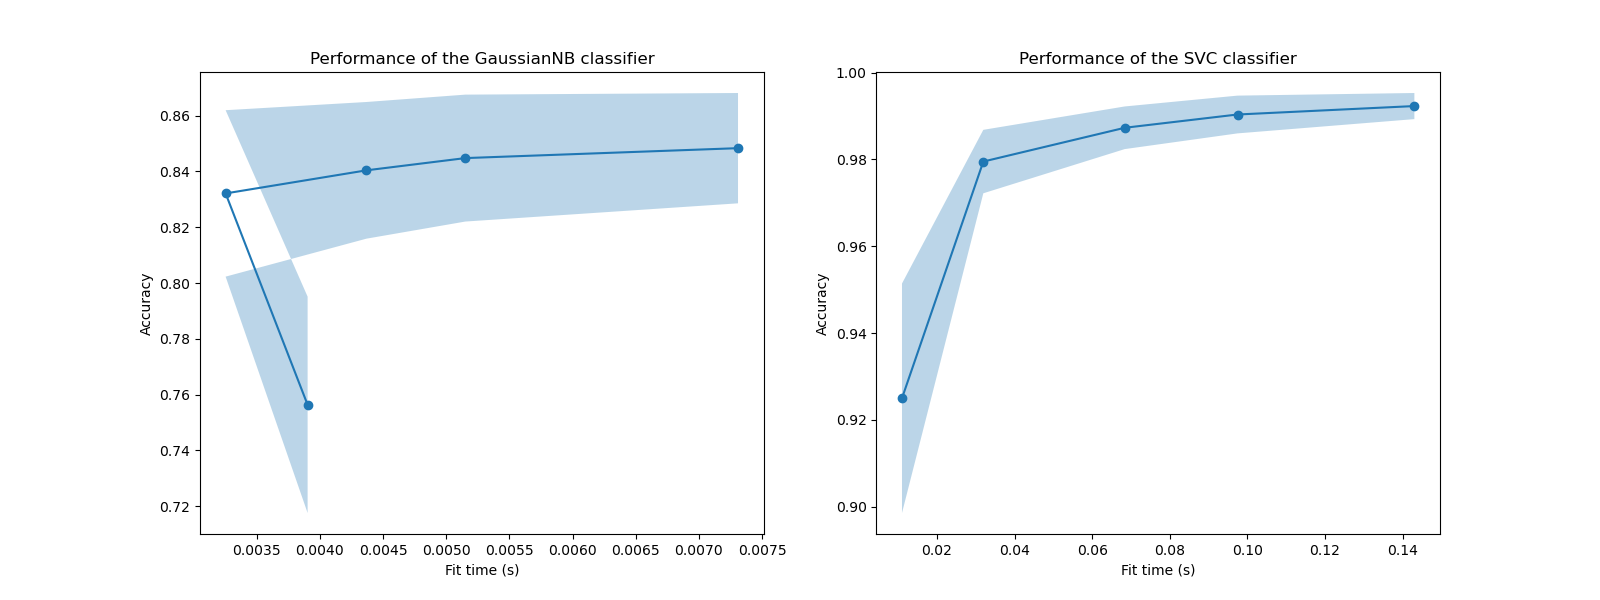
这张图对应交叉验证后的分析场景:看曲线可以判断继续加数据还是换模型更有效。
常见混淆: Cross-Validation 是一种评估方法,不是一种训练方法。它的目的是更准确地估计模型的泛化能力。
⚠️ 考试场景对比表
考试中经常出现"给定场景,选择合适的方法/算法/指标"类型的题目。下面的对比表覆盖了最常考的场景:
场景 → 算法选择
| 考试场景描述 | 推荐算法 | 原因 |
|---|---|---|
| 预测房价(连续数值) | Linear Regression | 简单回归问题 |
| 判断邮件是否为垃圾(是/否) | Logistic Regression | 二分类问题 |
| 将客户分成不同群体(无标签) | K-Means | 无监督聚类 |
| 图像识别(复杂非线性) | Neural Network / Deep Learning | 复杂模式识别 |
| 需要模型可解释性 | Decision Tree | 规则清晰,易于理解 |
| 高精度通用分类 | Random Forest | 集成学习,稳定性强 |
| 100+ 特征,需要降维 | PCA | 经典降维方法 |
| 机器人学习走路 | Reinforcement Learning | 试错 + 奖励信号 |
场景 → 评估指标选择
| 考试场景描述 | 推荐指标 | 原因 |
|---|---|---|
| 癌症检测(不能漏诊) | Recall | FN 代价极高 |
| 垃圾邮件过滤(不能误标正常邮件) | Precision | FP 代价高 |
| 99% 正常 + 1% 异常 | F1 / AUC-ROC | 数据不平衡 |
| 比较多个模型的整体能力 | AUC-ROC | 不受阈值影响 |
| 数据平衡的通用分类 | Accuracy | 直观简单 |
场景 → 问题诊断
| 考试场景描述 | 问题 | 解决方案 |
|---|---|---|
| 训练 95%,测试 60% | Overfitting | 正则化、增加数据、Dropout |
| 训练 55%,测试 50% | Underfitting | 增加复杂度、增加特征 |
| 训练/测试都好,上线后下降 | Model Drift | 重新训练、持续监控 |
| 准确率 99% 但没用 | 数据不平衡 | SMOTE、改用 F1/Recall |
📚 本章小结
本章深入讲解了机器学习的核心概念,这些内容在 AIF-C01 考试中会以各种场景题的形式出现:
- 监督学习算法: Linear Regression(回归)、Logistic Regression(分类,别被名字骗了)、Decision Tree(可解释性强)、Random Forest(集成学习、通用高精度)、Neural Network(复杂任务、低可解释性)
- 无监督学习算法: K-Means(聚类,需要预设 K 值)、PCA(降维,保留主要信息)
- 特征工程: Normalization、One-Hot Encoding、Feature Selection——花时间在这里比调参数更有效
- 数据预处理: 缺失值处理、异常值处理、不平衡数据集(SMOTE、Class Weights)
- 评估指标: Accuracy(平衡数据)、Precision(误报代价高)、Recall(漏报代价高)、F1(综合平衡)、AUC-ROC(模型对比)
- Confusion Matrix: TP、TN、FP、FN 是所有指标的基础
- Overfitting vs Underfitting: 训练好+测试差=过拟合,两个都差=欠拟合
- Bias-Variance Tradeoff: 简单模型高 Bias 低 Variance,复杂模型低 Bias 高 Variance
- 数据集划分: Train/Validation/Test,防止 Data Leakage
- Cross-Validation: K-Fold 方法更可靠地评估模型性能
下一章预告: 我们将进入考试权重第二高的 Domain 2——生成式 AI 基础。Transformer、Attention Mechanism、Tokenization、Prompt Engineering 等热门概念将全面展开。