
📖 生成式 AI 基础 (Fundamentals of Generative AI)
这一章对应 Domain 2: Fundamentals of Generative AI(24%),是整个 AIF-C01 考试中权重第二高的领域。如果说前两章是"地基",这一章就是"主体结构"——生成式 AI 是当前整个行业的核心热点,也是 AWS 考试出题最密集的区域之一。
从 ChatGPT 到 Stable Diffusion,从 Amazon Bedrock 到 CodeWhisperer,生成式 AI 正在重新定义我们与技术的交互方式。这一章会带你从底层原理到实际应用,把整个生成式 AI 的知识体系梳理清楚。
🎯 生成式 AI vs 传统 AI:根本区别是什么?
这是考试中一个高频考点——你必须清楚地区分 Generative AI 和 Traditional AI(尤其是 Discriminative AI)的本质区别。
Discriminative AI (判别式 AI)
Discriminative Model 学习的是"决策边界"——给定输入,判断它属于哪个类别。它回答的问题是"这是什么?"。
比喻:就像一个海关安检员,他只需要判断你的行李"是否有违禁品",不需要自己制造行李。
例子:
- 垃圾邮件分类器:判断邮件是垃圾还是正常
- 图像分类器:判断图片是猫还是狗
- 情感分析:判断评论是正面还是负面
Generative AI (生成式 AI)
Generative Model 学习的是数据的"内在分布"——理解数据长什么样,然后能创造出全新的、符合这个分布的数据。它回答的问题不仅是"这是什么",更重要的是"我能创造什么"。
比喻:判别式 AI 像一个美食评论家,能鉴定菜品的好坏;生成式 AI 像一个厨师,能自己创造新菜品。评论家只需要评判,厨师需要真正理解食材和烹饪的规律。
例子:
- 文本生成:写文章、写代码、翻译
- 图像生成:根据描述创建图片
- 代码生成:根据需求自动编写程序
核心对比
| 维度 | Discriminative AI | Generative AI |
|---|---|---|
| 核心任务 | 分类/预测 | 创造新内容 |
| 学习内容 | 决策边界 P(Y|X) | 数据分布 P(X) 或 P(X,Y) |
| 输入→输出 | 数据 → 标签/类别 | 提示/条件 → 新内容 |
| 典型模型 | SVM, Logistic Regression | GPT, DALL-E, Stable Diffusion |
| 比喻 | 鉴定师 | 创作者 |
| AWS 服务 | Amazon Comprehend, Rekognition | Amazon Bedrock, CodeWhisperer |
⚠️ 考试重点: 考试可能会问"以下哪个是生成式 AI 的应用?"选项中会混入分类、预测等判别式任务。关键判断标准是:有没有创造新内容? 如果只是分类或预测已知类别,就不是生成式 AI。
💡 进化之路:从 RNN 到 Transformer
理解生成式 AI,你需要了解它的技术演进脉络。每一代架构的出现都是为了解决前一代的局限性。
RNN (Recurrent Neural Network,循环神经网络)
RNN 是最早处理序列数据(文本、语音、时间序列)的神经网络架构。它的核心特点是:有"记忆"——处理每个元素时,会考虑之前处理过的内容。
比喻:就像你逐字阅读一句话。读到每个字时,你都会结合前面读过的内容来理解当前这个字的含义。
致命缺陷: 短期记忆问题。RNN 在处理长序列时,早期的信息会逐渐"遗忘"。想象你读一本 500 页的书,读到最后一页时已经忘了第一页写了什么。这叫做 Vanishing Gradient Problem (梯度消失问题)。
LSTM (Long Short-Term Memory,长短期记忆网络)
LSTM 是 RNN 的改进版,通过引入三个"门"结构(遗忘门、输入门、输出门)来控制信息的记忆和遗忘。
比喻:如果 RNN 是一个只能用脑子记事的人,LSTM 就是一个有笔记本的人。他可以选择性地记下重要信息(输入门)、划掉不重要的(遗忘门)、在需要时翻阅笔记(输出门)。
进步: 解决了 Vanishing Gradient Problem,能处理更长的序列。 局限性: 仍然是顺序处理,无法并行计算——处理一个词必须等前一个词处理完。这使得训练速度很慢,难以扩展到超大规模数据。
Transformer:改变一切的架构
2017 年 Google 发表了论文 "Attention Is All You Need",提出了 Transformer 架构。这篇论文彻底改变了 NLP 和整个 AI 领域的方向。GPT、BERT、Claude、LLaMA——所有你熟知的大语言模型都基于 Transformer。
Transformer 的革命性在于:它完全抛弃了 RNN 的顺序处理方式,用 Self-Attention Mechanism 实现了并行处理。
进化时间线
RNN (1980s)
  │  ✅ 能处理序列
  │  ❌ 短期记忆、无法并行
  ▼
LSTM (1997)
  │  ✅ 解决梯度消失、更长记忆
  │  ❌ 仍然顺序处理、训练慢
  ▼
Transformer (2017)
  │  ✅ 并行处理、全局注意力、可大规模扩展
  │  → GPT 系列 (Decoder-only): 文本生成
  │  → BERT (Encoder-only): 文本理解
  │  → T5 (Encoder-Decoder): 翻译、摘要
  ▼
Foundation Models (2020+)
     → GPT-4, Claude, LLaMA, PaLM
     → 百亿到万亿参数规模
⚠️ 考试重点: 考试会问 Transformer 相对于 RNN/LSTM 的优势。核心答案是两个:(1) 并行处理——训练速度快得多 (2) Self-Attention——能直接关注序列中任意位置的信息,不受距离限制。
🎯 Transformer 架构详解
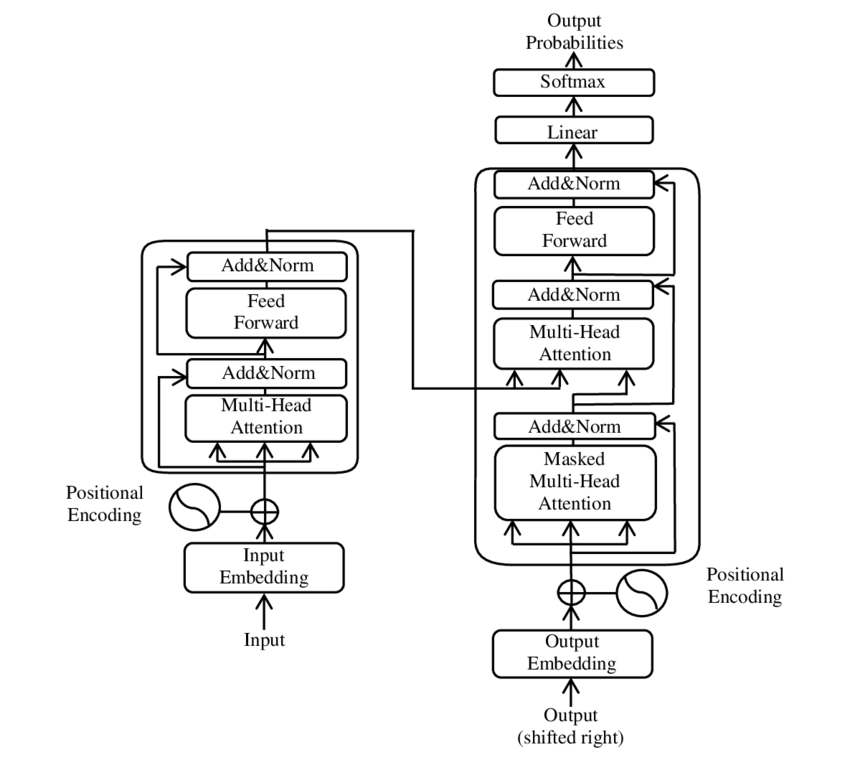
Transformer 是当前 AI 领域最重要的架构,你不需要理解每一个数学细节,但需要理解它的核心组件和工作原理。
整体结构
Transformer 由两个主要部分组成:
┌──────────────────────┐     ┌──────────────────────┐
│      Encoder          │     │      Decoder          │
│                        │     │                        │
│  ┌──────────────────┐ │     │ ┌──────────────────┐  │
│  │ Self-Attention    │ │     │ │ Masked            │  │
│  │                    │ │     │ │ Self-Attention     │  │
│  └──────────────────┘ │     │ └──────────────────┘  │
│          ↓             │     │         ↓              │
│  ┌──────────────────┐ │     │ ┌──────────────────┐  │
│  │ Feed-Forward      │ │────→│ │ Cross-Attention    │  │
│  │ Network           │ │     │ └──────────────────┘  │
│  └──────────────────┘ │     │         ↓              │
│                        │     │ ┌──────────────────┐  │
│  理解输入内容           │     │ │ Feed-Forward      │  │
│                        │     │ │ Network           │  │
└──────────────────────┘     │ └──────────────────┘  │
                              │                        │
                              │  生成输出内容           │
                              └──────────────────────┘
- Encoder: 理解输入内容,提取其中的含义和关系。BERT 就是只用 Encoder。
- Decoder: 基于理解的内容,逐步生成输出。GPT 就是只用 Decoder。
- Encoder-Decoder: 两者结合,典型的翻译模型(如 T5)先理解源语言,再生成目标语言。
Self-Attention Mechanism (自注意力机制)
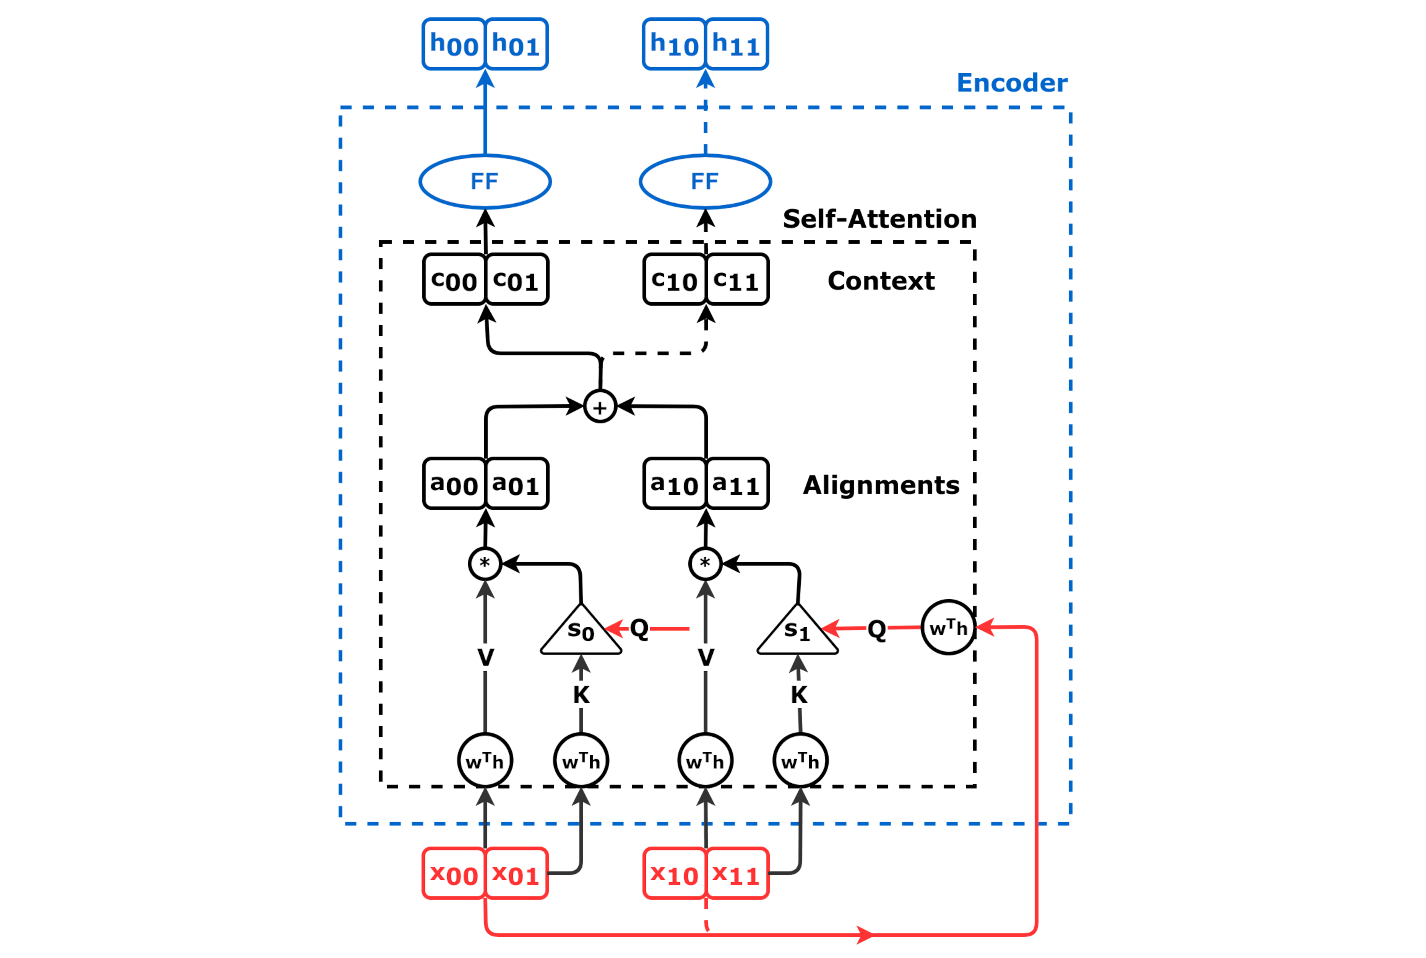
Self-Attention 是 Transformer 的灵魂。它让模型在处理一个词时,能"注意到"句子中所有其他词,并根据相关性分配不同的权重。
比喻:想象你在读一篇很长的文章。传统的 RNN 就像你被迫从头到尾逐字阅读,读到后面就忘了前面。Self-Attention 就像你面前有一本书的索引——你可以直接跳到任何相关的段落,了解上下文关系,不受距离限制。
举个具体例子,考虑这句话:
"The cat sat on the mat because it was tired."
"it"指的是什么?人类一眼就知道是"cat"。Self-Attention 的工作方式类似——它会计算"it"和句中所有其他词的关联度:
it → cat:     0.85  (高关联 ✓)
it → sat:     0.02
it → mat:     0.05
it → tired:   0.08
通过这种方式,模型能够正确理解"it"指代的是"cat"而不是"mat"。
Multi-Head Attention
实际的 Transformer 使用 Multi-Head Attention——同时运行多个 Self-Attention,每个"头"(Head) 关注不同的信息维度。
比喻:就像一个侦探组有 8 个侦探同时调查一个案件。一个关注时间线,一个关注人物关系,一个关注作案动机,一个关注物证。最后综合所有侦探的发现,得出更全面的结论。
Positional Encoding (位置编码)
因为 Self-Attention 是并行处理所有词的,它本身不知道词的顺序。"猫追狗"和"狗追猫"如果没有位置信息,对模型来说是一样的。
Positional Encoding 给每个词加上一个位置标记,让模型知道"这是第 1 个词"、"这是第 5 个词"。就像给队伍中的每个人发一个号码牌。
⚠️ 考试重点: 理解 Self-Attention 的核心价值——并行处理和全局关注。不需要背公式。如果题目问"Transformer 为什么比 RNN 训练更快",答案是 Self-Attention 允许并行计算。
💡 Tokenization:文字如何变成数字?
计算机不认识文字,只认识数字。Tokenization (分词/标记化) 是把文本拆分成模型能处理的最小单位(Token)的过程。
为什么需要 Tokenization?
模型不能直接处理 "Hello, how are you?" 这样的字符串。它需要先把文本拆成 Token,再把每个 Token 转换成数字(ID),才能送入神经网络计算。
常见 Tokenization 方法
Word-level Tokenization (词级)
最直观的方法:按空格和标点拆分。
"I love machine learning"
→ ["I", "love", "machine", "learning"]
问题: 词汇表会非常大,而且遇到没见过的词就无法处理(OOV,Out of Vocabulary)。
Character-level Tokenization (字符级)
按字符拆分。
"Hello"
→ ["H", "e", "l", "l", "o"]
问题: 序列变得很长,模型难以学习词义。
Subword Tokenization (子词级) — 目前主流
在词和字符之间找到平衡。常见的词保持完整,少见的词拆成更小的片段。
"unhappiness"
→ ["un", "happi", "ness"]

"playing"
→ ["play", "ing"]
BPE (Byte Pair Encoding)
BPE 是 GPT 系列使用的分词方法。它从字符开始,反复合并最频繁出现的字符对,直到达到预设的词汇表大小。
比喻:就像发明缩写。如果"the"出现了一万次,不如把它当成一个整体而不是三个字母。BPE 自动找到这些"值得缩写"的组合。
WordPiece
WordPiece 是 BERT 使用的分词方法,类似 BPE 但使用不同的合并策略(基于似然度而不是频率)。
"unbelievable"
→ WordPiece: ["un", "##believe", "##able"]
   (## 表示这个片段不是词的开头)
Token 和成本的关系
在使用大语言模型 API 时,Token 直接决定了费用。大多数 LLM 按 Token 数计费。一般来说,一个英文单词约等于 1-2 个 Token,一个中文字约等于 1-2 个 Token。
⚠️ 考试重点: 理解 Tokenization 的概念和意义即可。考试不会让你手动做 BPE 分词。重点是:(1) 为什么需要 Tokenization (2) Subword 方法的优势——在词汇量和序列长度之间取得平衡。
🎯 Embeddings:把词变成有意义的数字
Embedding (嵌入/向量化) 是把 Token 转换成固定长度的数字向量(一串数字)的过程。它不是简单地给每个词一个编号,而是把语义信息编码到数字中。
为什么不能用简单的编号?
如果"猫"=1,"狗"=2,"汽车"=100。这些数字暗示了"猫和狗的差距"等于"猫和汽车差距"的 1/99。但实际上,猫和狗的语义距离应该远小于猫和汽车。简单编号无法表达语义关系。
向量空间中的语义
Embedding 把每个词映射到一个高维向量空间中。在这个空间里,语义相似的词距离更近。
向量空间示意(简化为 2D):

     ↑ 维度2
     │
     │    ● king          ● queen
     │
     │         ● man   ● woman
     │
     │                        ● car
     │  ● cat                ● truck
     │  ● dog
     │
     └──────────────────────────→ 维度1
更神奇的是,Embedding 能捕捉类比关系:
king - man + woman ≈ queen
Paris - France + Japan ≈ Tokyo
这说明模型不仅学会了词的含义,还学会了词与词之间的关系。
Embedding 的实际维度
实际的 Embedding 不是 2D 或 3D,而是高维的:
- Word2Vec: 100-300 维
- BERT: 768 维
- GPT-3: 12288 维
维度越高,能表达的语义信息越丰富,但也需要更多的计算资源。
AWS 中的 Embedding 服务
- Amazon Bedrock: 提供 Titan Embeddings 模型,可以把文本转换成向量
- Amazon OpenSearch: 支持向量搜索(Vector Search),用于语义检索
⚠️ 考试重点: 理解 Embedding 的核心概念——把文本转成向量,语义相似的文本在向量空间中距离更近。这是 RAG (Retrieval-Augmented Generation) 和语义搜索的基础,会在 Domain 3 中大量考查。
💡 Pre-training, Fine-tuning 与 RLHF Pipeline
大语言模型的训练不是一步完成的,而是一个多阶段的 pipeline。理解每个阶段的目的和方法对考试非常重要。
Stage 1: Pre-training (预训练)
Pre-training 是用海量无标注文本数据训练模型的阶段。模型通过预测下一个 Token(GPT 方式)或填充被遮住的 Token(BERT 方式)来学习语言的基本规律。
比喻:就像一个孩子在成长过程中大量阅读各种书籍。他不是为了做任何特定的事情,只是在积累对语言和世界的"通用理解"。
特点:
- 数据量极大(TB 级别的文本)
- 计算成本极高(数百万美元)
- 学到的是通用知识,不是特定任务的技能
- 通常只有大公司(AWS、OpenAI、Google)才有资源做
训练方式:
- Causal Language Modeling (CLM): 预测下一个 Token。GPT 系列使用这种方式。
- Masked Language Modeling (MLM): 随机遮住一些 Token,让模型预测被遮住的内容。BERT 使用这种方式。
CLM 示例:
输入: "The cat sat on the"
目标: "mat"

MLM 示例:
输入: "The [MASK] sat on the mat"
目标: "cat"
Stage 2: Fine-tuning (微调)
Fine-tuning 是在预训练模型的基础上,用特定领域或任务的标注数据进一步训练,让模型学会完成特定任务。
比喻:预训练后的模型就像一个通识教育毕业的大学生。Fine-tuning 就是让他读研究生,在特定领域(医疗、法律、金融)深造。他不需要从零学起,只需要在已有知识的基础上进行专业化训练。
Fine-tuning 的类型:
| 类型 | 说明 | 数据需求 | 计算成本 |
|---|---|---|---|
| Full Fine-tuning | 更新模型所有参数 | 大 | 很高 |
| LoRA (Low-Rank Adaptation) | 只更新少量新增参数 | 中 | 较低 |
| Adapter Tuning | 在模型中插入小型适配器层 | 中 | 较低 |
| Prompt Tuning | 只优化提示的 embedding | 少 | 低 |
AWS 服务: Amazon Bedrock 支持对 Foundation Model 进行 Fine-tuning(Custom Model Training)。Amazon SageMaker 提供更灵活的 Fine-tuning 环境。
Stage 3: RLHF (Reinforcement Learning from Human Feedback)
RLHF 是让模型学习如何生成"人类偏好的"回答的训练方法。这是 ChatGPT 之所以"好用"的核心秘密之一。
比喻:Fine-tuning 让模型学会了"能做什么",RLHF 让模型学会了"怎么做才让人满意"。就像一个厨师不仅会做菜(Fine-tuning),还知道食客喜欢什么口味(RLHF)。
RLHF 的三步流程:
Step 1: 收集人类偏好数据
  → 给人类标注者展示同一问题的多个回答
  → 标注者排序哪个回答更好

Step 2: 训练 Reward Model (奖励模型)
  → 用人类偏好数据训练一个模型
  → 这个模型能自动给回答打分

Step 3: 用 RL 优化生成模型
  → 模型生成回答 → Reward Model 打分 → 模型学习生成更高分的回答
  → 使用 PPO (Proximal Policy Optimization) 等 RL 算法
完整 Pipeline 总结
Pre-training          Fine-tuning              RLHF
(海量无标注数据)     (特定任务标注数据)      (人类偏好数据)
     │                     │                      │
     ▼                     ▼                      ▼
学习语言基础知识  →  学习特定任务技能  →  学习生成人类偏好的输出
     │                     │                      │
 通用基础模型         专业领域模型           对齐的最终模型
⚠️ 考试重点: 区分 Pre-training、Fine-tuning 和 RLHF 的目的和数据需求。Pre-training 用无标注数据学通用知识(成本极高),Fine-tuning 用标注数据学特定任务(成本中等),RLHF 用人类反馈对齐偏好(需要人工标注者)。
🎯 生成式模型的类型
生成式 AI 不仅限于文本生成。它已经扩展到图像、代码、音频、视频等多个领域。
Text Generation (文本生成)
代表模型: GPT-4, Claude, LLaMA, Amazon Titan Text
文本生成模型基于 Transformer Decoder 架构,通过预测下一个 Token 来逐步生成文本。
应用场景: 写作辅助、翻译、摘要、问答、代码解释。
AWS 服务: Amazon Bedrock 提供多个文本生成模型(Anthropic Claude、Amazon Titan、AI21 Jurassic 等)。
Image Generation (图像生成)
代表模型: Stable Diffusion, DALL-E, Midjourney, Amazon Titan Image Generator
图像生成模型通常使用 Diffusion (扩散) 技术:先向图像添加噪声直到完全变成随机噪点,然后训练模型学会从噪声中"恢复"出图像。
比喻:就像雕塑。你从一块随机的石头(噪声)开始,一点点凿掉不需要的部分(去噪),最终得到一个精美的雕塑(生成的图像)。
应用场景: 产品设计、广告素材、概念可视化、艺术创作。
AWS 服务: Amazon Bedrock 提供 Stability AI (Stable Diffusion) 和 Amazon Titan Image Generator。
Code Generation (代码生成)
代表模型: CodeWhisperer (AWS), GitHub Copilot, Code Llama
代码生成模型是在大量代码数据上 Fine-tuning 的文本生成模型。它们理解编程语言的语法、逻辑和最佳实践。
应用场景: 代码补全、代码生成、Bug 修复、代码解释、测试用例生成。
AWS 服务: Amazon CodeWhisperer(现已更名为 Amazon Q Developer)提供实时代码建议。
Multi-modal Models (多模态模型)
Multi-modal Model 能同时处理和生成多种类型的数据——文本、图像、音频、视频等。
比喻:早期的 AI 像是只有单一感官的人——有的只能"看"(图像模型),有的只能"读"(文本模型)。Multi-modal Model 就像一个五感健全的人,能同时看、听、读、写。
代表模型: GPT-4V (文本+图像), Gemini (文本+图像+音频+视频)
AWS 服务: Amazon Bedrock 上的 Claude 3 系列支持多模态输入(文本+图像)。
生成式模型类型对比
| 类型 | 输入 | 输出 | 代表模型 | AWS 服务 |
|---|---|---|---|---|
| Text | 文本提示 | 文本 | GPT-4, Claude | Amazon Bedrock |
| Image | 文本描述 | 图像 | Stable Diffusion | Bedrock (Stability AI) |
| Code | 注释/需求 | 代码 | CodeWhisperer | Amazon Q Developer |
| Multi-modal | 文本+图像 | 文本/图像 | Claude 3, GPT-4V | Bedrock (Claude 3) |
💡 Prompt Engineering:与模型对话的艺术
Prompt Engineering (提示工程) 是设计和优化输入提示,以从语言模型中获得更好输出的技术和策略。这不仅是一项实用技能,也是 AIF-C01 考试的重要考点。
Zero-shot Prompting (零样本提示)
Zero-shot 是直接给模型一个任务描述,不提供任何示例。模型仅凭预训练中学到的知识来回答。
Prompt: "将以下文本翻译成英文: 今天天气很好"

Output: "The weather is nice today"
适用场景: 任务简单明确,模型的预训练知识足以处理。
Few-shot Prompting (少样本提示)
Few-shot 是在 Prompt 中给出几个示例(通常 2-5 个),让模型从示例中理解你期望的输入-输出格式和任务要求。
Prompt:
"判断以下评论的情感:

评论: '这个产品太棒了!' → 正面
评论: '质量很差,很失望' → 负面
评论: '包装不错,但功能一般' → ?"

Output: "中性"
适用场景: 需要模型按特定格式输出,或任务有一定复杂度。
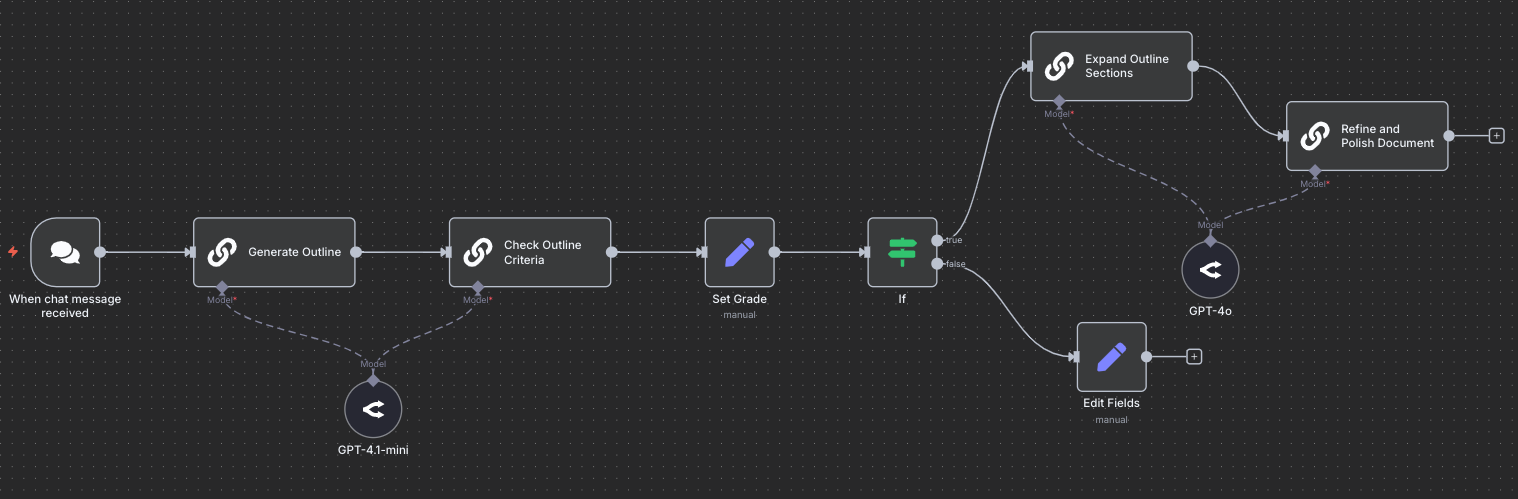
这张图用于理解“复杂任务分解”考点:当单个 Prompt 不稳定时,拆成多段链式提示通常更容易拿到稳定结果。
比喻:Zero-shot 像是把一个任务描述扔给同事,希望他自己理解。Few-shot 像是先做几个示范,再让他照着做——成功率自然高得多。
Chain-of-Thought (CoT) Prompting (思维链提示)
Chain-of-Thought 是引导模型在回答前先展示推理过程的技术。通过让模型"一步步想",能显著提高复杂推理任务的准确率。
普通 Prompt:
"如果一个商店有 15 个苹果,卖出 7 个,又进了 12 个,现在有多少?"

Chain-of-Thought Prompt:
"如果一个商店有 15 个苹果,卖出 7 个,又进了 12 个,现在有多少?
请一步一步思考。"

模型回答:
"让我一步步计算:
1. 开始有 15 个苹果
2. 卖出 7 个:15 - 7 = 8 个
3. 又进了 12 个:8 + 12 = 20 个
所以现在有 20 个苹果。"
为什么有效? 因为语言模型是逐 Token 生成的。让模型先生成推理步骤,相当于让它"思考"——每一步的输出都成为下一步推理的上下文。
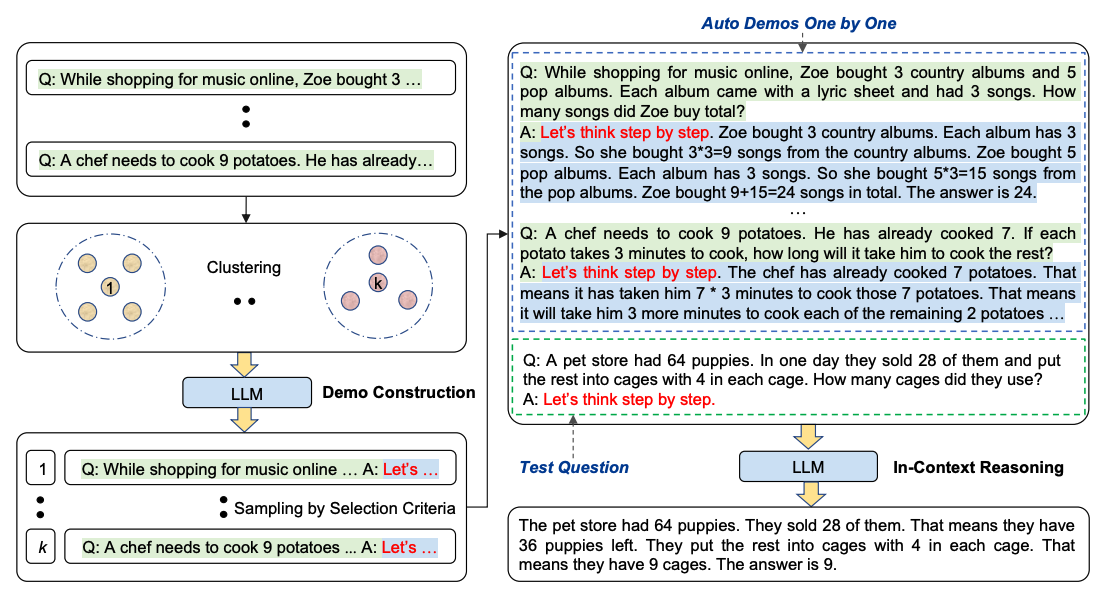
这张图补充了 CoT 的进阶形态:考试若出现“如何在复杂推理任务中稳定提升表现”,可联想到 CoT/Auto-CoT 方案。
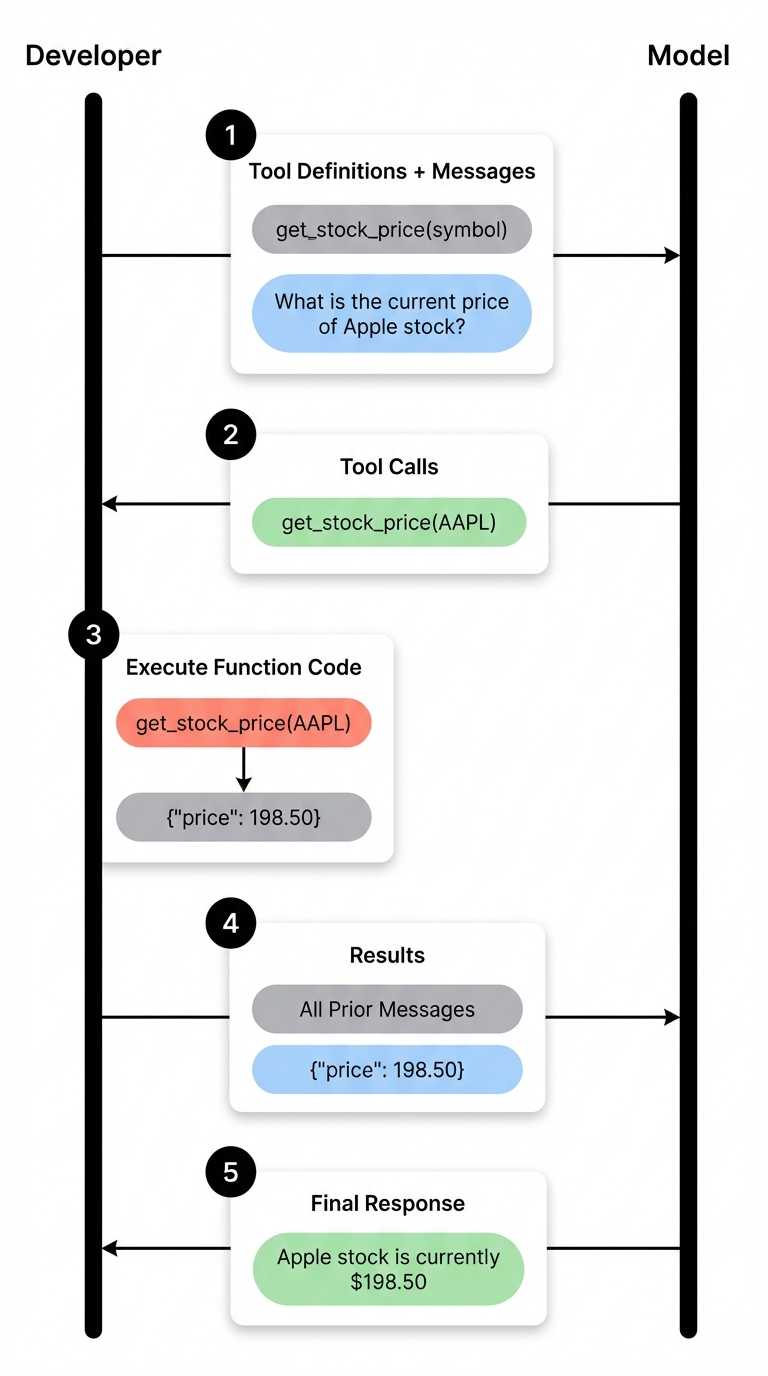
这张图用于理解“模型会调用工具但不直接执行”的考点,适合区分 LLM 推理与外部系统执行边界。
Prompt Engineering 策略对比
| 策略 | 提供示例 | 适用场景 | 复杂度 |
|---|---|---|---|
| Zero-shot | 0 个 | 简单任务、常见任务 | 低 |
| One-shot | 1 个 | 格式化输出 | 低 |
| Few-shot | 2-5 个 | 特定格式、领域任务 | 中 |
| Chain-of-Thought | 可选 | 推理、数学、逻辑 | 中 |
| System Prompt | N/A | 设定角色和约束 | 低-中 |
⚠️ 考试重点: 考试会给你一个场景,让你选择最合适的 Prompting 策略。如果任务涉及推理和计算,Chain-of-Thought 是首选。如果需要特定输出格式,Few-shot 是首选。如果任务简单直接,Zero-shot 就够了。
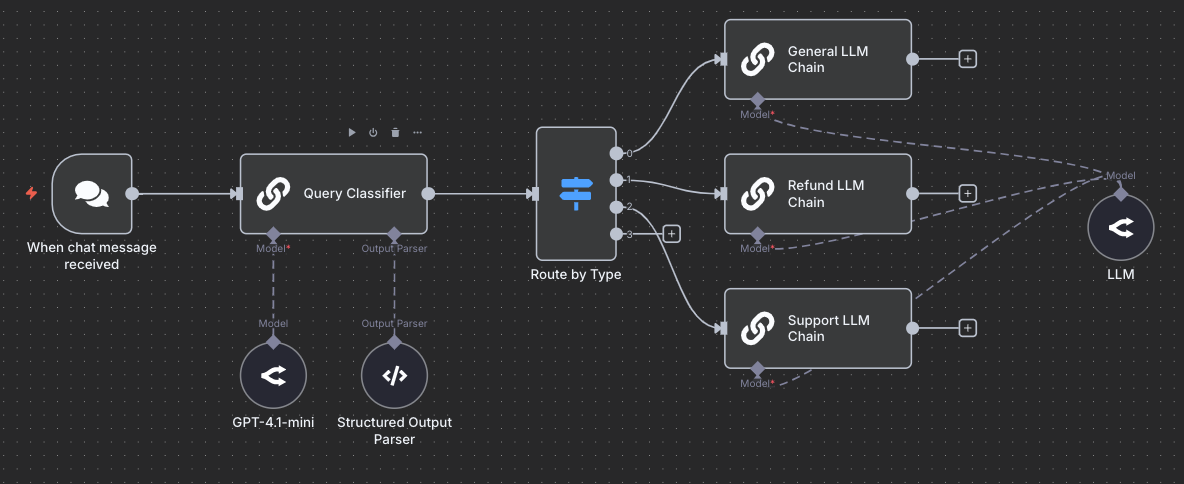
这张图对应“路由策略”场景:题目出现多任务混合输入时,先路由再生成往往比单模型硬答更稳。
🎯 Temperature, Top-P, Top-K:控制生成的"创造力"
这三个参数控制模型生成文本时的"随机性"和"创造力"。理解它们对于使用 Amazon Bedrock 等服务至关重要。
Temperature (温度)
Temperature 控制生成结果的随机性。值越高,输出越多样和有创意;值越低,输出越确定和保守。
比喻:Temperature 就像一个"创意旋钮"。开到最低(0),模型总是给你最"安全"的答案(就像一个保守的会计师)。开到最高(1 或以上),模型开始"天马行空"(就像一个充满灵感的艺术家)。
| Temperature 值 | 效果 | 适用场景 |
|---|---|---|
| 0 | 完全确定性,每次输出一样 | 事实回答、代码生成 |
| 0.1-0.3 | 很保守,偶有小变化 | 翻译、摘要 |
| 0.4-0.7 | 平衡创意和准确性 | 对话、写作 |
| 0.8-1.0 | 高创意,多样性强 | 创意写作、头脑风暴 |
| >1.0 | 非常随机,可能不连贯 | 很少使用 |
Top-P (Nucleus Sampling,核采样)
Top-P 设置一个累积概率阈值。模型只从概率之和达到 P 值的最小 Token 集合中采样。
举例:如果 Top-P = 0.9,模型会找到概率最高的若干 Token,直到它们的概率之和达到 90%,然后只从这些 Token 中选择。剩下的 10% 概率的 Token 被排除,它们通常是低概率的"离谱"选项。
Token 概率排列:
"happy" = 0.40
"glad"  = 0.25
"joyful" = 0.15
"elated" = 0.10
"potato" = 0.05  ← Top-P=0.9 会排除这个
"banana" = 0.03  ← 以及这个
"xyz"    = 0.02  ← 以及这个
Top-K
Top-K 更简单直接:只从概率最高的 K 个 Token 中选择。
- Top-K = 1: 只选概率最高的 Token(贪心解码,完全确定性)
- Top-K = 10: 从概率最高的 10 个 Token 中选择
- Top-K = 50: 更大的选择范围,更多样的输出
三个参数的关系
| 参数 | 控制什么 | 值小时 | 值大时 |
|---|---|---|---|
| Temperature | 概率分布的"平坦度" | 更确定 | 更随机 |
| Top-P | 候选 Token 的概率范围 | 更保守 | 更多样 |
| Top-K | 候选 Token 的数量 | 更保守 | 更多样 |
实践建议:
- 通常只调 Temperature 和 Top-P 中的一个,不同时调
- 事实性任务:Temperature=0, Top-P=1
- 创意任务:Temperature=0.7-0.9, Top-P=0.9-0.95
⚠️ 考试重点: 如果题目描述"模型输出太随机/不可预测",答案是降低 Temperature 或 Top-P/Top-K。如果描述"模型输出太单调/重复",答案是提高这些参数。这是非常直接的场景题。
💡 Hallucination:模型为什么会"胡说八道"?
Hallucination (幻觉) 是指模型生成的内容看起来很合理,但实际上是事实错误的或完全捏造的。这是当前生成式 AI 最大的挑战之一,也是考试中 Responsible AI 相关的核心考点。
为什么会产生 Hallucination?
-
训练数据不完整: 模型的知识来源于训练数据。如果训练数据中没有某个事实,模型只能"猜测",而它的"猜测"可能看起来很有道理却完全错误。
-
模型本质是模式匹配: 语言模型本质上是在预测"什么 Token 最可能出现在这里"。它不是在"理解"事实,而是在做统计推测。如果"张三是诺贝尔奖获得者"这种表述在统计上"合理",模型就可能生成它,不管张三是否真的获过奖。
-
知识截止日期: 模型的训练数据有截止日期,对于此后发生的事件一无所知,但可能会"自信地"给出错误答案。
-
缺乏事实验证机制: 模型在生成时没有内置的"事实检查器"。它只关注语言的流畅性和连贯性,不关注事实准确性。
Hallucination 的类型
| 类型 | 说明 | 例子 |
|---|---|---|
| 事实性错误 | 生成错误的事实信息 | "澳大利亚的首都是悉尼"(应该是堪培拉) |
| 捏造引用 | 编造不存在的论文/文献 | 引用一个根本不存在的研究论文 |
| 逻辑矛盾 | 前后说法不一致 | 先说A是对的,后面又说A是错的 |
| 过度自信 | 对不确定的事情给出确定性答案 | 对一个有争议的话题给出绝对性结论 |
如何缓解 Hallucination?
| 方法 | 说明 | AWS 相关 |
|---|---|---|
| RAG (Retrieval-Augmented Generation) | 让模型在生成前先检索相关文档,基于事实来回答 | Amazon Bedrock Knowledge Bases |
| Grounding (接地) | 把模型的回答锚定在可验证的数据源上 | Amazon Kendra + Bedrock |
| 温度调低 | 降低 Temperature 减少随机性 | Bedrock API 参数 |
| Prompt 设计 | 明确告诉模型"如果不确定就说不知道" | Prompt Engineering |
| Human-in-the-loop | 人工审核模型输出 | Amazon A2I (Augmented AI) |
| Fine-tuning | 用高质量数据微调,减少错误知识 | SageMaker / Bedrock |
| Guardrails | 设置输出过滤和验证规则 | Amazon Bedrock Guardrails |
⚠️ 考试重点: RAG 是 AWS 官方推荐的缓解 Hallucination 的首选方法。如果考试问"如何减少模型幻觉",RAG 几乎一定是正确答案之一。另外,Bedrock Guardrails 也是一个重要的安全机制。
🎯 考试场景对比表
场景 → 模型类型选择
| 考试场景描述 | 推荐模型类型 | 原因 |
|---|---|---|
| 需要生成营销文案 | Text Generation (LLM) | 创造新的文本内容 |
| 需要根据描述生成产品图片 | Image Generation (Diffusion) | 从文本生成图像 |
| 需要自动完成代码 | Code Generation | 基于上下文生成代码 |
| 需要同时理解图片并回答问题 | Multi-modal Model | 处理多种数据类型 |
| 需要判断邮件是否为垃圾邮件 | Discriminative Model | 分类任务,非生成任务 |
| 需要发现客户购买模式 | Unsupervised ML | 模式发现,非生成任务 |
场景 → Prompt 策略选择
| 考试场景描述 | 推荐策略 | 原因 |
|---|---|---|
| 简单翻译任务 | Zero-shot | 任务简单明确 |
| 需要特定 JSON 输出格式 | Few-shot | 示例展示期望格式 |
| 复杂数学推理 | Chain-of-Thought | 需要逐步推理 |
| 需要稳定一致的回答 | Temperature=0 | 消除随机性 |
| 创意写作,需要多样性 | Temperature=0.8+ | 增加随机性 |
场景 → 训练策略选择
| 考试场景描述 | 推荐方法 | 原因 |
|---|---|---|
| 从零开始构建 LLM | Pre-training | 需要完整训练(成本极高) |
| 让通用模型适应医疗领域 | Fine-tuning | 在已有模型基础上专业化 |
| 让模型回答更像人类偏好 | RLHF | 对齐人类偏好 |
| 减少模型幻觉 | RAG | 基于检索的事实锚定 |
| 低成本适应新领域 | LoRA / Prompt Tuning | 参数高效的微调方法 |
场景 → 问题解决
| 考试场景描述 | 问题 | 解决方案 |
|---|---|---|
| 模型生成的内容事实错误 | Hallucination | RAG、Guardrails、降温 |
| 模型输出太随机不稳定 | 高随机性 | 降低 Temperature/Top-P |
| 模型输出太重复单调 | 低多样性 | 提高 Temperature/Top-P |
| 模型不理解特定领域术语 | 领域知识不足 | Fine-tuning 或 RAG |
| 模型输出不安全/有害内容 | 安全问题 | Bedrock Guardrails |
📚 本章小结
本章覆盖了 AIF-C01 考试 Domain 2(24%权重)的核心内容。这是整个考试中最与时俱进的部分,也是最容易拉开分数差距的领域:
- Generative AI vs Discriminative AI: 生成式 AI 创造新内容,判别式 AI 做分类预测。关键判断标准是"是否创造了新内容"。
- 技术进化路线: RNN → LSTM → Transformer。Transformer 的核心优势是并行处理和 Self-Attention。
- Transformer 架构: Encoder(理解)+ Decoder(生成),Self-Attention 让模型能关注任意位置的信息。GPT 用 Decoder,BERT 用 Encoder。
- Tokenization: 文本→Token→数字。BPE (GPT) 和 WordPiece (BERT) 是主流方法。Subword 方法在词汇量和序列长度之间取得平衡。
- Embeddings: 把 Token 变成有意义的数字向量。语义相似的词在向量空间中距离更近。这是 RAG 和语义搜索的基础。
- 训练 Pipeline: Pre-training(通用知识)→ Fine-tuning(特定任务)→ RLHF(人类偏好对齐)。
- 生成式模型类型: Text (GPT/Claude)、Image (Stable Diffusion)、Code (CodeWhisperer)、Multi-modal (Claude 3/GPT-4V)。
- Prompt Engineering: Zero-shot(无示例)、Few-shot(有示例)、Chain-of-Thought(逐步推理)。
- 生成参数: Temperature(创意旋钮)、Top-P(概率阈值)、Top-K(候选数量)。低值=保守确定,高值=创意多样。
- Hallucination: 模型生成看似合理但实际错误的内容。RAG 是 AWS 推荐的首选缓解方法。
下一章预告: 我们将进入考试权重最高的 Domain 3——基础模型应用(28%)。Amazon Bedrock、Foundation Models、RAG 架构、Agent 系统等实战内容将全面展开。这是与 AWS 服务结合最紧密的章节。