匠人学院 JR Academy
  • Position

    我现在在哪,该往哪走?

    几道题看你现在的岗位受 AI 影响多大、机会在哪。免费,不用注册。

    免费看看我现在在哪

    AI 对职业的影响

    我的工作会被 AI 替代吗常见职业的 AI 影响与转型方向AI 时代的新岗位做什么、要求什么、怎么转过去AI 影响自测几道题看你所在岗位的风险和机会

    测一测

    能力测评AI Engineer 面试准备度自测职业性格测试找到和你性格匹配的方向职业规划回答几个问题,看可能适合的职业回国求职评估按学校、专业、毕业时间看回国机会
  • Skill

    不知道该学什么 AI?

    先按方向免费学,每个方向从入门讲到动手做;想系统学再看训练营和导师。

    按方向免费开始学

    按方向免费学

    Vibe Coding用 AI 写代码,零基础可学AI 办公提效文档、表格、汇报用 AI 省时间Prompt 大师把需求说清楚的写法AI EngineerRAG、Agent、MCP 工程实践AI 数据分析用 AI 做查询、清洗和报表全部学习方向 →

    训练营与课程

    全部训练营按职业方向、难度、形式筛选AI Engineer Bootcamp从 LLM 应用到 Agent 的工程训练营人人都能学的 AI Coding非技术背景的 AI 编程实战AI 工作流提效营在职人士的 AI 工作流导师团队一线工程师与行业导师全部课程 →

    动手练与资料

    互动 LabPrompt、前端、Python、AWS 在线练学习路线图一张图看清该按什么顺序学Cheat Sheets语言与工具速查表Wiki 知识库AI 工具与概念讲解视频讲座、公开课、学员分享免费资源 →
  • Evidence

    拿什么让雇主相信你?

    证书、项目、团队实战、比赛作品,最后整理成一份作品档案。

    了解作品档案

    考证

    考证匠 · 全部认证AWS、Azure、GCP、Claude 等备考与模考AWS SAA-C03云架构师入门认证Azure AI-102微软 AI 工程师认证Claude 认证Anthropic Claude 系列认证模拟考试按真实考试界面限时练全部认证 →

    项目与团队实战

    P3 团队实战和真人协作做项目,模拟实习式的团队流程P3 项目经历P3 项目能写进简历的部分Demo Day项目成果展示P3 证书完成项目后的证明P3 全部 →

    比赛与作品

    黑客松限时做出一个作品提交作品把你的项目放进作品展示CareerOS 作品档案在桌面版做任务,提交的结果整理成作品
    考证匠浏览器插件 + App + 小程序截屏分析考题,随时刷题了解考证匠
  • Connect

    怎么把自己推出去?

    简历、面试、内推、导师。先看你和目标岗位差多少,再决定从哪补。

    用求职匠开始

    简历与机会

    毕业生求职澳洲、中国、马来西亚、新加坡、美国、英国求职准备求职匠AI 求职工作台:改简历、找岗位、投递AI 简历对照 JD 改写简历内推机会学员和导师分享的内推岗位机会实习、项目和合作机会Offer 榜学员拿到的 Offer

    面试

    AI 模拟面试文字或语音练一次,看差在哪面试中心按公司和岗位找题面经真实面试经历System Design 手册系统设计面试准备面试全部 →

    导师

    1v1 导师按小时约 AI、求职、技术导师拼团私教几个人一起上,每人更便宜职业辅导服务简历、面试、方向的辅导套餐成为导师加入匠人导师团队
    求职匠桌面版一个工作台管完整求职在 macOS/Windows 整理真实经历,按岗位完善简历版本。了解求职匠
  • Community

    去哪认识同路的人?

    讲座、公开课、Workshop、黑客松,线上线下都有。

    看近期活动

    活动类型

    讲座行业嘉宾分享公开课免费试听课程内容Workshop动手做一个小作品黑客松组队限时开发新生节开学季的校园活动

    城市

    悉尼悉尼的线下活动墨尔本墨尔本的线下活动布里斯班布里斯班的线下活动线上在哪都能参加全部活动 →

    社群

    职业社区求职者互助学习小组找人一起学Discord在线交流群
企业会员下载 CareerOS
匠人学院 JR Academy学AI来匠人

Follow Us

linkedinfacebooktwitterinstagramweiboyoutubebilibilitiktokxigua

We Accept

/image/layout/pay-paypal.png/image/layout/pay-visa.png/image/layout/pay-master-card.png/image/layout/pay-airwallex.png/image/layout/pay-alipay.png
EN
产品

CareerOS 与工具

  • CareerOS
  • 考证匠
  • 求职匠
  • 求职匠网页版
  • 求职匠分析报告
  • 求职匠桌面版下载
  • 我的求职报告
  • 购买报告次数
  • 求职匠账单
  • AI 工具箱
  • AI Skill 商城

会员与课程

  • 会员
  • AI 会员
  • AI Engineer VIP
  • 训练营
  • Training Camp
  • 看板学习
  • AI Builder 课程
  • MCP 课程
  • NotebookLM Workshop
  • Business Analyst 课程
  • Web全栈班
  • DevOps项目班
  • 数据工程全栈班
  • 数据分析项目班
  • 编程入门班
  • 算法集训营

求职服务

  • 毕业生求职
  • 澳洲毕业生求职
  • 中国毕业生求职
  • 马来西亚毕业生求职
  • 新加坡毕业生求职
  • 美国毕业生求职
  • 英国毕业生求职
  • 1v1 辅导
  • 职业辅导
  • BA和产品经理实习
  • 数据科学实习
  • 数据分析实习
  • Marketing实习
  • 简历修改
  • 面试指导
  • 岗位代投
  • 职位监控
  • LinkedIn代运营
  • LinkedIn人脉代加
内容库

学习方向

  • 全部学习方向
  • AI Engineer
  • Context Engineering
  • Vibe Coding
  • Prompt Master
  • AI Builder
  • AI 产品经理
  • Python 入门
  • AI 办公提效
  • AI 数据分析
  • AI 财务
  • AI 内容创作
  • AI 视觉创作
  • 前端开发
  • Hermes Agent
  • OpenClaw 本地智能体

互动 Lab

  • Prompt Lab
  • Frontend Lab
  • JavaScript Lab
  • Python Lab
  • AWS Lab
  • Azure Lab
  • LLM Lab
  • Git Lab

资料与指南

  • Wiki 知识库
  • 学习 Wiki
  • Cheat Sheets
  • 学习路线图
  • AI 路线图
  • 视频
  • 博客
  • 面试手册
  • 模拟考试
  • 免费资源

城市

  • 悉尼
  • 墨尔本
  • 布里斯班
  • 阿德莱德
  • 新加坡
  • 吉隆坡
  • 伦敦
  • 纽约
  • 旧金山
  • 洛杉矶
  • 西雅图
  • 多伦多
  • 温哥华

移民

  • 澳洲移民
  • 技术移民189/190/491
  • 雇主担保482/186/494
  • 投资移民188/888
  • 英国移民
  • 美国移民
  • 加拿大移民
  • 新加坡移民
  • 马来西亚移民
企业

企业服务

  • AI for Business
  • 企业门户登录
  • 企业培训
  • 实习合作
  • 招聘合作
  • Enterprise (EN)

Metatree AI Lab

  • Metatree AI Lab
  • AI 解决方案
  • 数字员工
  • 案例
  • Metatree AI Lab(英文)
  • AI Services(英文)
  • Digital Employee(英文)
  • Work(英文)

青少年 AI 教育

  • Airbotix 少儿 AI 编程
  • 澳洲家长实用资料库
  • NAPLAN 成绩单怎么看
  • My School 学校数据指南
  • 悉尼私校学费 2026
  • 少儿编程课程与训练营
关于

公司

  • 关于我们
  • 匠人导师
  • 成为导师
  • 新闻资讯
  • 元宇宙课堂
  • 匠人工作
  • 匠人商店J3.Club
  • 联系我们

帮助与条款

  • 常见问题
  • 服务条款
  • 隐私政策
  • 取消与退款政策
  • 网站地图

联系

  • hello@jiangren.com.au
  • 0421-672-555

地址

Level 10b, 144 Edward Street, Brisbane CBD (Headquarter)
Level 2, 171 La Trobe St, Melbourne VIC 3000
四川省成都市武侯区桂溪街道天府大道中段500号D5东方希望天祥广场B座45A13号
Business Hub, 155 Waymouth St, Adelaide SA 5000

Disclaimer

footer-disclaimerfooter-disclaimer

JR Academy acknowledges Traditional Owners of Country throughout Australia and recognises the continuing connection to lands, waters and communities. We pay our respect to Aboriginal and Torres Strait Islander cultures; and to Elders past and present. Aboriginal and Torres Strait Islander peoples should be aware that this website may contain images or names of people who have since passed away.

匠人学院网站上的所有内容,包括课程材料、徽标和匠人学院网站上提供的信息,均受澳大利亚政府知识产权法的保护。严禁未经授权使用、销售、分发、复制或修改。违规行为可能会导致法律诉讼。通过访问我们的网站,您同意尊重我们的知识产权。JR Academy Pty Ltd 保留所有权利,包括专利、商标和版权。任何侵权行为都将受到法律追究。查看用户协议

© 2017-2026 JR Academy Pty Ltd. All rights reserved.

ABN 26621887572

首页学习AI课程考证
跳至正文
学习指南
Polars 高性能数据分析指南

Polars 是用 Rust 编写的高性能 DataFrame 库,速度比 Pandas 快 10-100 倍。

1 个章节·1 篇指南·按章节权限阅读
开始阅读 ↓
官方文档 ↗GitHub ↗
Polars 简介

Polars 高性能数据分析指南

快速入门

  • Polars 简介

相关链接

  • ↗官方文档
  • ↗GitHub
  1. 首页
  2. 学技能
  3. Wiki 知识库
  4. Polars 高性能数据分析指南
本页内容
先说结论:你到底该不该换 Polars核心区别:不只是快,是思路完全不一样惰性求值 = 点菜制 vs 自助餐并行执行 = 高铁 vs 绿皮火车没有 Index = 少掉 80% 的坑迁移指南:Pandas → Polars 对照表读写数据选列和过滤聚合和分组新增列和修改合并和连接最容易翻车的地方1. 忘了 collect(),拿到的是 LazyFrame 不是 DataFrame2. 习惯性写 apply / map,性能直接崩3. 字符串比较用错了4. 列名重复时 join 会报错5. 不支持就地修改版本注意事项适不适合你:Checklist性能实测参考跟 DuckDB 怎么选相关资源

Polars:让你的数据处理快到离谱

你第一次用 Polars 大概是这样的:Pandas 跑了 3 分钟的脚本,你抱着试试看的心态换成 Polars,8 秒跑完。你盯着终端看了半天,以为哪里写错了,结果一检查——数据完全正确。

这不是夸张,我在一个 2GB 的 CSV 清洗任务上亲身经历过。当时 Pandas 的 read_csv + groupby + merge 一套下来要 4 分钟,Polars 的 lazy mode 同样逻辑 11 秒结束。那一刻我就知道,这玩意不是玩具。


#先说结论:你到底该不该换 Polars

我直接给结论,省得你翻到最后:

  • 数据量 < 100MB:别折腾,Pandas 够用,生态也更成熟
  • 数据量 100MB - 1GB:可以试试,尤其你已经受不了 Pandas 的速度
  • 数据量 > 1GB:强烈建议换,Polars 的优势是碾压级的
  • 数据量 > 10GB:Polars + scan_parquet 的 lazy mode 是你为数不多的选择之一(另一个是 DuckDB)

一句话:如果你现在的 Pandas 脚本跑得你想去泡杯咖啡,那就是该换的时候了。


#核心区别:不只是快,是思路完全不一样

先看对比表:

对比项PolarsPandas
底层语言RustC/Cython
执行模式惰性求值 + 自动并行即时求值、单线程
内存格式Apache Arrow 列式存储NumPy 行式
API 风格链式表达式、不可变就地修改、索引驱动
大数据表现可处理超出内存的数据全部塞进内存,塞不下就炸
多线程自动用满所有 CPU 核心默认单线程,手动并行很痛苦
Index没有 Index 这个概念到处都是 Index,经常搞混

Polars 官方 Logo
Polars 官方 Logo

但光看表格感受不到本质区别,我用几个类比说清楚。说到这个我想起来,我第一次接触 Polars 其实是在一个同事的 PR review 里看到的,当时还以为是个小众玩具库,结果一试直接真香。

#惰性求值 = 点菜制 vs 自助餐

Pandas 是自助餐模式:你每写一行代码,它立刻执行。df.filter() 马上算,df.groupby() 也马上算。哪怕下一步你要把这个中间结果扔掉,它也老老实实算完了。

Polars 的 lazy mode 是点菜制:你一口气写完所有操作,它先不动,等你说 .collect() 的时候,才把所有操作一起优化、一起执行。就像你在餐厅点了 5 道菜,厨房会把能一起炒的一起炒,而不是做完一道上一道。

python
# Pandas:每一步都立刻执行,中间产生大量临时 DataFrame df = pd.read_csv("huge.csv") # 全部读进内存 df = df[df["age"] > 30] # 马上过滤,产生新 DataFrame df = df.groupby("city").agg({"salary": "mean"}) # 马上聚合 # Polars lazy:先攒着,最后一起算 result = ( pl.scan_csv("huge.csv") # 不读,只记住"要读这个文件" .filter(pl.col("age") > 30) # 不算,只记住"要过滤" .group_by("city") # 不算 .agg(pl.col("salary").mean()) # 不算 .collect() # 这时候才一口气全算完,自动优化执行计划 )

这个差距在简单操作上感觉不大,但一旦链路长了、数据大了,Polars 的查询优化器能帮你省掉大量不必要的计算。

#并行执行 = 高铁 vs 绿皮火车

Pandas 本质上是单线程的。你的电脑有 8 个核,Pandas 只用 1 个,剩下 7 个在看戏。

Polars 用 Rust 的 Rayon 库自动把任务分配到所有 CPU 核心。你不用写任何多线程代码,它自己搞定。这就像高铁和绿皮火车的区别——不是绿皮火车司机技术差,而是轨道和车本身就不在一个级别。

#没有 Index = 少掉 80% 的坑

说实话,Pandas 的 Index 是我见过最容易让新手翻车的设计。reset_index()、set_index()、merge 之后 Index 乱掉、MultiIndex 搞不清层级……这些坑你踩过几个?

Polars 直接砍掉了 Index。行就是行,列就是列,没有隐藏的 Index 在背后搞事情。最省力的办法就是不给你犯错的机会。


想补上 Polars 高性能数据分析指南?先看清你差在哪

说说你现在做什么、想去哪,按技能、证据、经验、表达、定位五类看差在哪、先补什么。不用登录。

对照我的情况

#迁移指南:Pandas → Polars 对照表

已经会 Pandas 的人,看这个表就能快速上手:

#读写数据

python
# Pandas # Polars pd.read_csv("f.csv") pl.read_csv("f.csv") # eager pl.scan_csv("f.csv") # lazy(推荐) pd.read_parquet("f.parquet") pl.read_parquet("f.parquet") pl.scan_parquet("f.parquet") # lazy df.to_csv("out.csv") df.write_csv("out.csv") df.to_parquet("out.parquet") df.write_parquet("out.parquet")

#选列和过滤

python
# Pandas # Polars df["col"] df["col"] 或 df.select("col") df[["a", "b"]] df.select("a", "b") df[df["age"] > 30] df.filter(pl.col("age") > 30) df.loc[0:5] df.head(5) 或 df.slice(0, 5) df.query("age > 30 & city == 'SYD'") df.filter((pl.col("age") > 30) & (pl.col("city") == "SYD"))

#聚合和分组

python
# Pandas # Polars df.groupby("city")["sal"].mean() df.group_by("city").agg(pl.col("sal").mean()) df.groupby("city").agg({ df.group_by("city").agg([ "sal": "mean", pl.col("sal").mean(), "age": ["min", "max"] pl.col("age").min(), }) pl.col("age").max(), ])

#新增列和修改

python
# Pandas # Polars df["new"] = df["a"] + df["b"] df = df.with_columns((pl.col("a") + pl.col("b")).alias("new")) df["cat"] = df["x"].apply(func) df = df.with_columns(pl.col("x").map_elements(func)) df.rename(columns={"a": "b"}) df.rename({"a": "b"}) df.drop(columns=["x"]) df.drop("x")

#合并和连接

python
# Pandas # Polars pd.merge(df1, df2, on="id") df1.join(df2, on="id") pd.concat([df1, df2]) pl.concat([df1, df2])

#最容易翻车的地方

这几个坑我自己或者身边人都踩过,提前告诉你:

#1. 忘了 collect(),拿到的是 LazyFrame 不是 DataFrame

python
result = pl.scan_csv("data.csv").filter(pl.col("age") > 30) print(result) # 输出的是执行计划,不是数据! # 你得加 .collect() print(result.collect())

新手最常见的困惑就是"为什么打印出来不是数据"。记住:scan_ 开头的返回 LazyFrame,必须 .collect() 才能拿到真正的 DataFrame。

#2. 习惯性写 apply / map,性能直接崩

这个坑我见过不止一次了。有个真实案例:之前组里一个实习生写了个数据清洗脚本,用 Polars 跑反而比 Pandas 还慢,大家都懵了。最后一看代码,满屏的 map_elements(lambda ...),等于把 Polars 的 Rust 引擎完全绕过去了,全程在跑 Python 解释器。改成原生表达式之后,速度直接快了 40 多倍。

python
# ❌ 这样写 Polars 会退化成跟 Pandas 一样慢 df = df.with_columns( pl.col("name").map_elements(lambda x: x.upper()) ) # ✅ 用 Polars 原生表达式,快几十倍 df = df.with_columns( pl.col("name").str.to_uppercase() )

能用内置表达式的就别用 lambda,这是 Polars 性能的第一铁律。顺便提一嘴,Polars 的表达式 API 覆盖面其实非常广,字符串、时间、数学运算基本都有原生支持,真正需要写 lambda 的场景没你想的那么多。

#3. 字符串比较用错了

python
# ❌ Pandas 思维:直接比较 df.filter(pl.col("status") == "active") # 这个没问题 # ❌ 但 contains 不一样 df.filter(pl.col("name").str.contains("张")) # ✅ 注意是 .str.contains()

Polars 的字符串操作都在 .str 命名空间下,跟 Pandas 的 .str 类似但不完全一样。

#4. 列名重复时 join 会报错

join 的时候同名列记得加 suffix:

python
df1.join(df2, on="id", suffix="_right")

#5. 不支持就地修改

Pandas 里你可以 df["col"] = xxx,Polars 里 DataFrame 是不可变的(immutable)。所有修改都返回新的 DataFrame:

python
# Pandas 思维(Polars 里不行) df["new_col"] = values # Polars 方式 df = df.with_columns(pl.lit(values).alias("new_col"))

#版本注意事项

Polars 更新非常快,API 经常有 breaking changes。几个建议:

  • 锁定版本:requirements.txt 里写死版本号,比如 polars==1.27.0,不要用 >=
  • 关注 changelog:大版本升级前看一眼 GitHub Releases↗,重点看 Breaking Changes 部分
  • 0.x → 1.0 的迁移:如果你还在用 0.x 版本,升级到 1.0 有不少 API 变化,比如 groupby 改成了 group_by,apply 改成了 map_elements
  • Python 版本:建议 Python 3.9+,Polars 已经不支持 3.8

#适不适合你:Checklist

在决定之前,过一遍这个清单:

适合用 Polars 的情况:

  • 你的数据处理脚本跑得慢,成为了工作瓶颈
  • 你愿意花 1-2 天学新 API(跟 Pandas 像但不完全一样)
  • 你主要做 ETL、数据清洗、聚合分析
  • 你的数据格式是 CSV、Parquet、JSON
  • 你不需要大量用 .plot() 画图(Polars 本身没有画图功能)

暂时不适合的情况:

  • 你的项目深度依赖 scikit-learn、statsmodels 等只接受 Pandas 的库
  • 团队里只有你一个人会 Polars,其他人都用 Pandas
  • 数据量很小,当前性能完全够用
  • 你需要大量交互式探索(Jupyter 里 Pandas 的体验目前还是更好)

一个折中方案:核心计算逻辑用 Polars,最后转成 Pandas 喂给其他库:

python
# Polars 处理完,转 Pandas 给 sklearn polars_df = pl.scan_parquet("data.parquet").filter(...).group_by(...).agg(...).collect() pandas_df = polars_df.to_pandas() model.fit(pandas_df[features], pandas_df[target])

#性能实测参考

以下是一些典型操作在 1GB CSV 上的大致耗时对比(具体数字取决于机器配置,这里给个数量级的感觉):

操作PandasPolars (eager)Polars (lazy)
读取 CSV~15s~3s~2s (scan)
过滤行~2s~0.3s~0.1s
GroupBy 聚合~5s~0.8s~0.5s
Join 两表~8s~1.2s~0.8s
写 Parquet~3s~1s~1s

注意:lazy mode 的时间包含了 .collect() 的时间。Polars 在 Parquet 格式上优势更大,因为 Arrow 和 Parquet 天生兼容,不需要格式转换。

下面这张是 Polars 官方的 TPC-H 基准测试结果(Scale Factor 10),可以直观看到各个查询上的耗时对比:
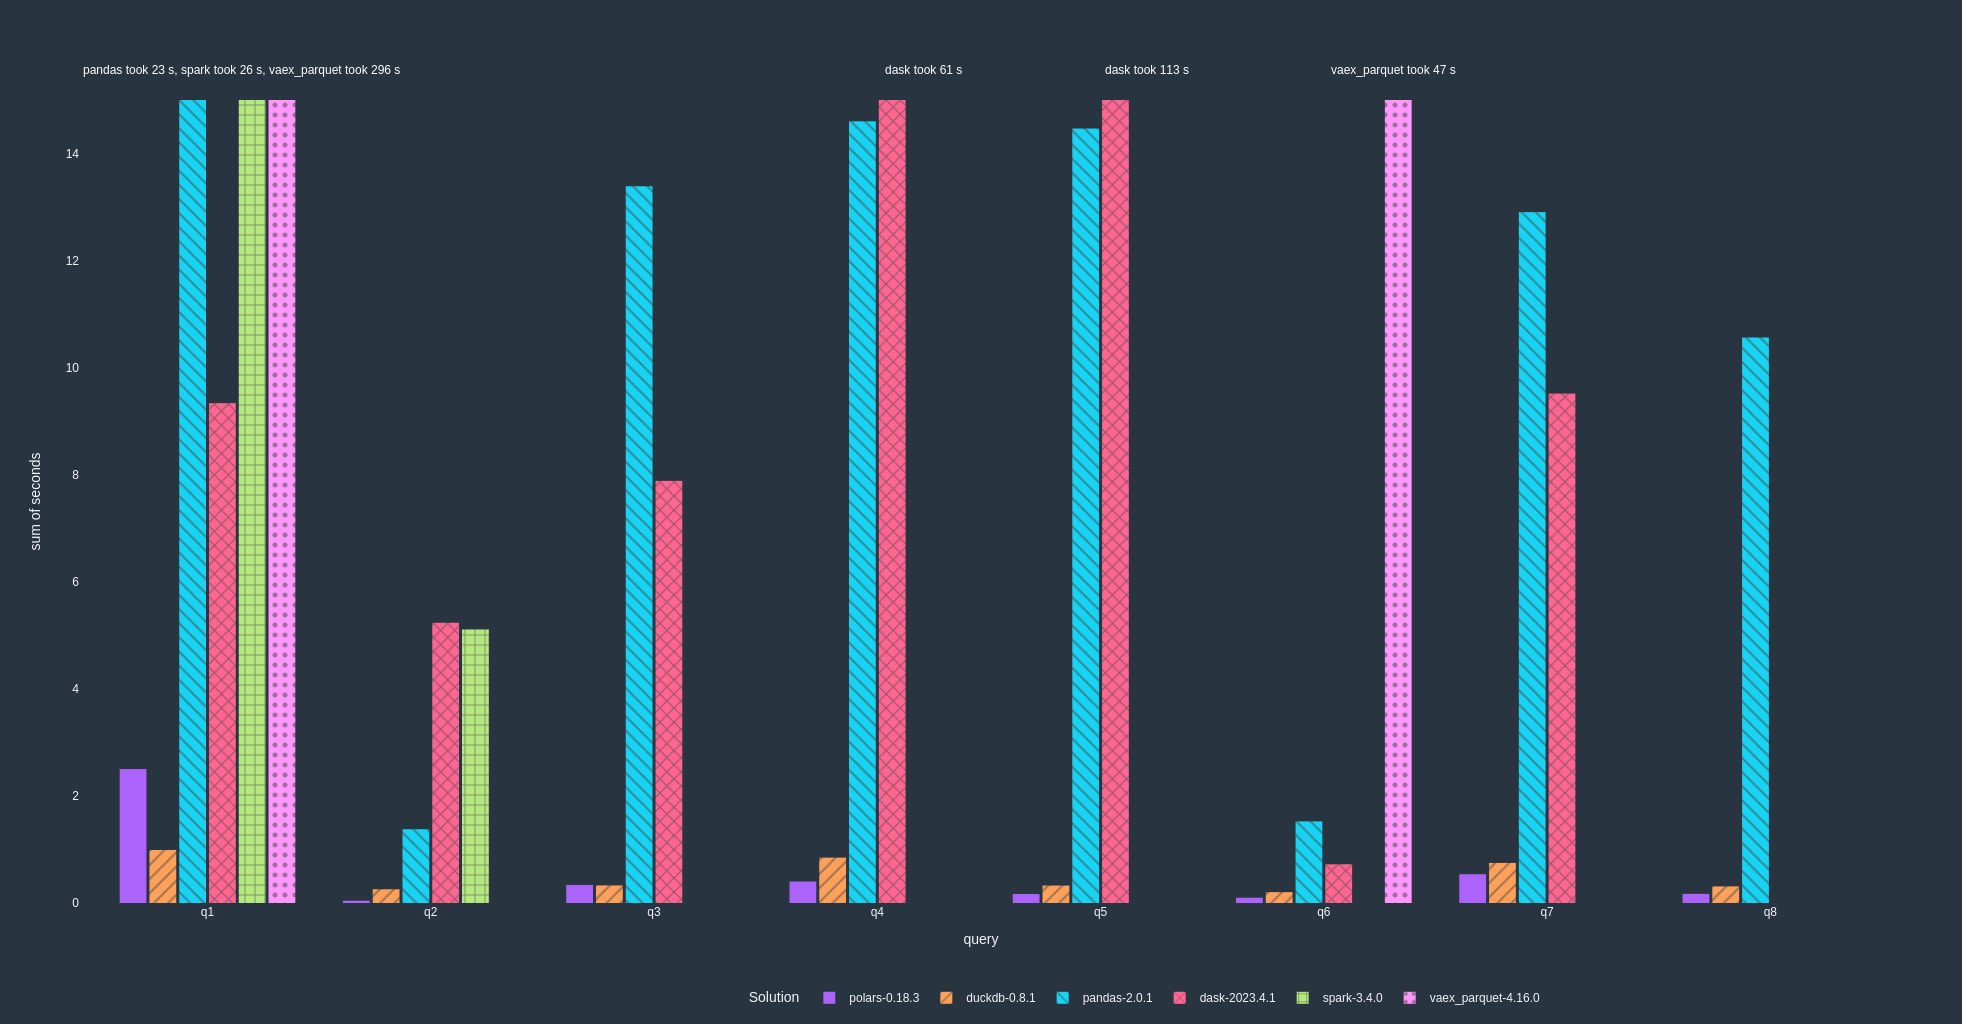
Polars TPC-H Benchmark (SF=10)


#跟 DuckDB 怎么选

这个问题被问得很多。简单说:

  • Polars:Python DataFrame 库,API 是 Python 风格的链式调用,适合写数据处理 pipeline
  • DuckDB:嵌入式数据库,API 是 SQL,适合喜欢写 SQL 的人

两者性能差不多,都很快。选哪个主要看你更喜欢写 Python 表达式还是 SQL。也可以一起用,DuckDB 能直接查询 Polars DataFrame。


#相关资源

官方:

  • Polars 官网:https://pola.rs↗
  • Polars 文档:https://docs.pola.rs↗
  • Polars GitHub:https://github.com/pola-rs/polars↗
  • Polars 速查表:https://docs.pola.rs/user-guide/↗

相关 Wiki:

  • Pandas Wiki — 如果你还没学 Pandas,建议先学 Pandas 再来看 Polars
  • DuckDB Wiki — 另一个高性能数据处理方案,用 SQL 的方式
  • Apache Arrow Wiki — Polars 底层的内存格式

推荐学习路径:

  1. 先跑通官方的 Getting Started,感受一下速度差异
  2. 把一个现有的 Pandas 脚本迁移过来,对照上面的对照表改
  3. 重点学 Expression API,这是 Polars 最强大的部分
  4. 理解 lazy vs eager 的区别,日常优先用 lazy mode
发布团队
JR Academy
学习资料

个人作者与审校人按实际记录署名。

免费资源

精选免费资料与工具合集

课程、工具与资料一站式获取。

查看免费资源 →

相关指南

Pandas 数据分析指南Pandas 数据分析指南→
DuckDB 分析数据库指南DuckDB 分析数据库指南→
Jupyter Notebook 指南Jupyter Notebook 指南→

相关路线图

ai-engineer→

常见问题

Polars 和 Pandas 选哪个?
小数据集两者都行,大数据集(GB级)强烈推荐 Polars。Polars 的惰性求值和并行计算让它在性能上碾压 Pandas。
Polars 学习成本高吗?
如果你熟悉 Pandas,Polars 的 API 设计很相似,上手很快。主要区别在于惰性求值模式和表达式语法。

看完了,下一步

想补上 Polars 高性能数据分析指南?先看清你差在哪

说说你现在做什么、想去哪,按技能、证据、经验、表达、定位五类看差在哪、先补什么。不用登录。

对照我的情况
  • 定位按岗位看学习路线图前端、后端、数据、AI 等方向,按阶段列出要学的内容和先后顺序。看全部路线图 →
  • 技能常用命令和语法速查Git、Linux、Python、SQL 等常用写法整理在一页,写代码时随手查。看 Cheat Sheets →
  • 技能按方向免费学 AIVibe Coding、AI 办公、Prompt、AI Engineer 等方向,按章节从入门学起。看全部学习方向 →

目录

  • Polars:让你的数据处理快到离谱
  • 先说结论:你到底该不该换 Polars
  • 核心区别:不只是快,是思路完全不一样
  • 惰性求值 = 点菜制 vs 自助餐
  • Pandas:每一步都立刻执行,中间产生大量临时 DataFrame
  • Polars lazy:先攒着,最后一起算
  • 并行执行 = 高铁 vs 绿皮火车
  • 没有 Index = 少掉 80% 的坑
  • 迁移指南:Pandas → Polars 对照表
  • 读写数据
  • Pandas # Polars
  • 选列和过滤
  • Pandas # Polars
  • 聚合和分组
  • Pandas # Polars
  • 新增列和修改
  • Pandas # Polars
  • 合并和连接
  • Pandas # Polars
  • 最容易翻车的地方
  • 1. 忘了 collect(),拿到的是 LazyFrame 不是 DataFrame
  • 你得加 .collect()
  • 2. 习惯性写 apply / map,性能直接崩
  • ❌ 这样写 Polars 会退化成跟 Pandas 一样慢
  • ✅ 用 Polars 原生表达式,快几十倍
  • 3. 字符串比较用错了
  • ❌ Pandas 思维:直接比较
  • ❌ 但 contains 不一样
  • 4. 列名重复时 join 会报错
  • 5. 不支持就地修改
  • Pandas 思维(Polars 里不行)
  • Polars 方式
  • 版本注意事项
  • 适不适合你:Checklist
  • Polars 处理完,转 Pandas 给 sklearn
  • 性能实测参考
  • 跟 DuckDB 怎么选
  • 相关资源

这项技能你需要补吗?

带上这页的主题,对照你的情况看差在哪。

对照我的情况